DeepSeek V4 Flash 实测:8 块钱跑完一个完整任务
Claude Science 绿皮书 · 番外 01 · 2026-08-01
 封面:Claude Science 绿皮书 番外01 · 8 块钱的一夜
7 月以来我在 Claude Science 里跑任务,卡住我的从来不是模型够不够聪明。是钱,和断线。
省流
之前我一直推 GLM 5.2,它好用,但两天能把我一个月的额度烧光,烧光就断在半路。V4 Flash 把这两条一起解了:一整夜 70M tokens,8 块钱,中途没断。代价是它没有眼睛。
- 痛点不在能力,在烧得太快、断得太勤。
- 现在:输出 $0.28/M,缓存命中 $0.0028/M,长任务能无人值守自己滚。
- 它看不见图,改一版丑一版,偶尔吐乱码,视觉的活得另外接。
一、最大的痛点叫 GLM 5.2
先把话说在前面:GLM 5.2 好用。逻辑深度够,做科研类的活很稳,我推过它很多次,到现在也不收回。
问题是它太贵。不是单价看着贵,是在 Claude Science 这种几十轮循环的用法里贵得让人不敢放手跑。
我 OpenCode Go 订阅、中转、官网三种入口都跑过,结果都一样——用着用着就断了。断的原因就两条:
- 额度烧完,任务只能停在半路。 不是它不会做,是做到一半没钱了。
- 烧得太快。 状态好的时候两天能把一整个月的额度清空。
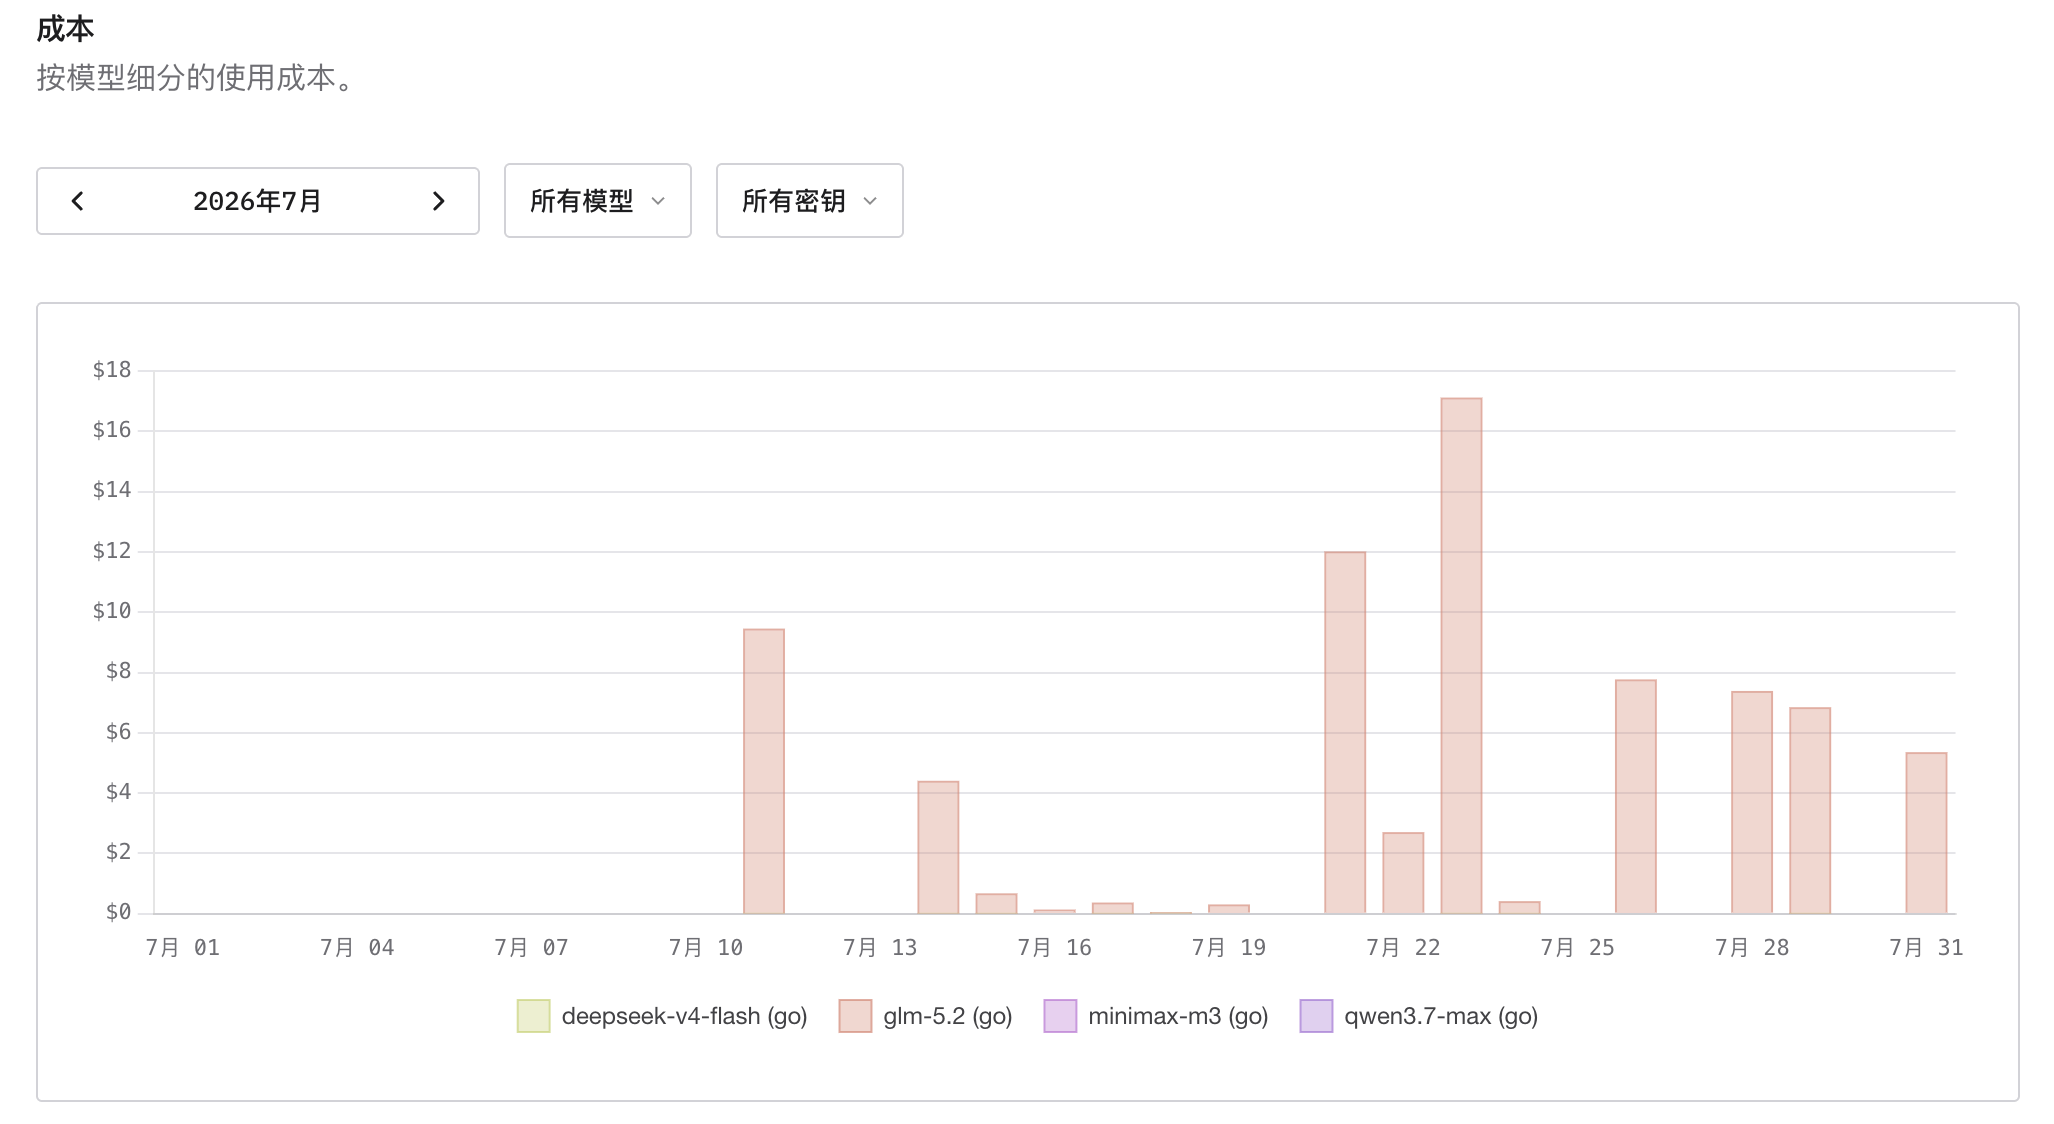 图 1:七月成本图,橙柱几乎全是 GLM 一个模型
长任务最怕的就是断。断一次,前面几十轮的上下文全白烧,重跑又是一笔钱。所以我一直在等一个东西:便宜到我敢丢长任务,稳到它能自己跑完。
二、7 月 31 日,V4 Flash 放出 0731 刷新版
等来了。模型名 deepseek-v4-flash,284B 总参数 / 13B 激活,MIT 开源,目前是公开 beta。
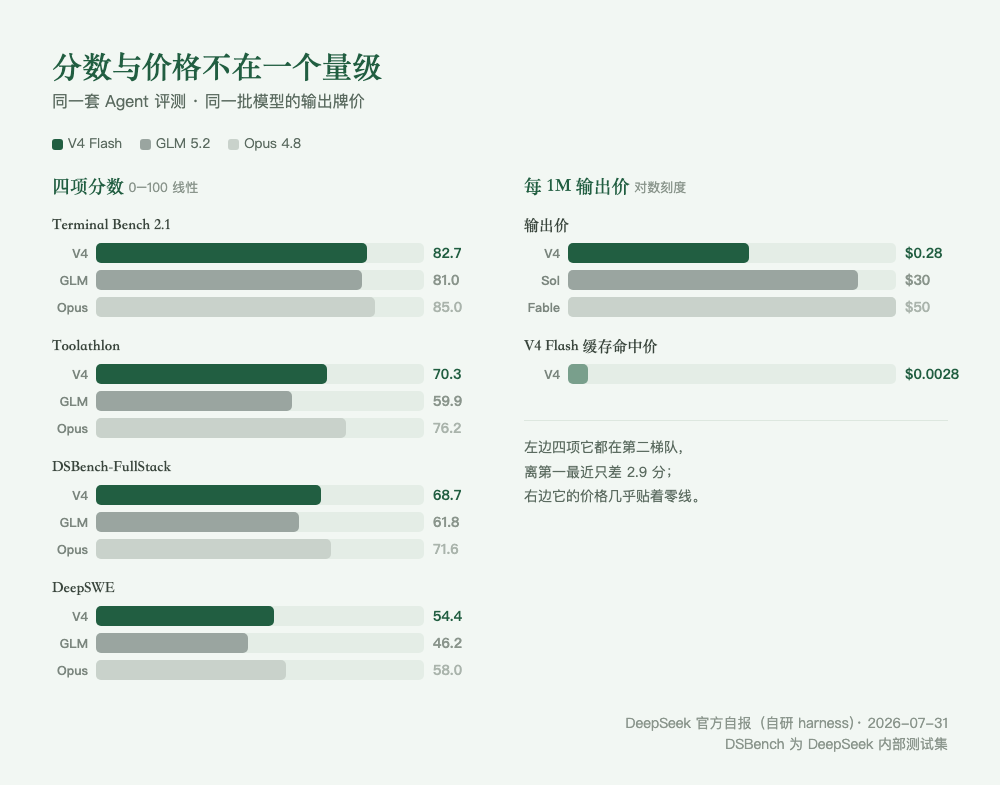 图 2:分数排第二梯队,价格不在一个量级
| 项 | V4 Flash | 对照 |
|---|---|---|
| 输入 | $0.14 / 1M | Sol $5 / 1M、Fable 5 $10 / 1M |
| 输出 | $0.28 / 1M | Sol $30 / 1M、Fable 5 $50 / 1M |
| 缓存命中 | $0.0028 / 1M | Sol $0.50 / 1M、Fable 5 $1.00 / 1M |
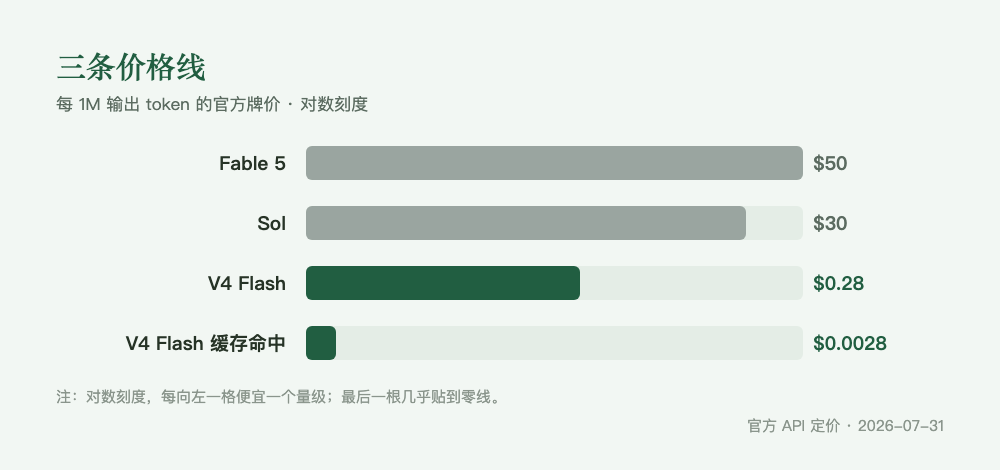 图 3:同一栏输出价,差一百倍以上
它的分数也不是聊天榜上的分数:Terminal Bench 2.1 82.7、Toolathlon 70.3、DSBench-FullStack 68.7、DeepSWE 54.4。四项全在第二梯队,离 Opus-4.8 最近一项只差 2.9 分,且都比 GLM 5.2 高。Artificial Analysis 的 Intelligence Index 给它 50 分,同类中位数是 25;而它的输入输出单价都在中位数以下(中位数 $0.43 / $1.20)。
对我最实际的是另一件事:它原生吃 Codex / Responses API。我切的时候没改一行代码,改个模型名就跑起来了。
三、8 块钱,70M tokens,一整夜
当晚我丢了一个完整任务下去,就在 Claude Science 里:读数据、跑实验分析、调本地工具、看报错、改代码、再验证,来回滚了一整夜。睡前我的心理价位是三位数。
早上打开:70M tokens,¥8.48。我盯着那个数字看了好几秒,第一反应是页面没刷新。
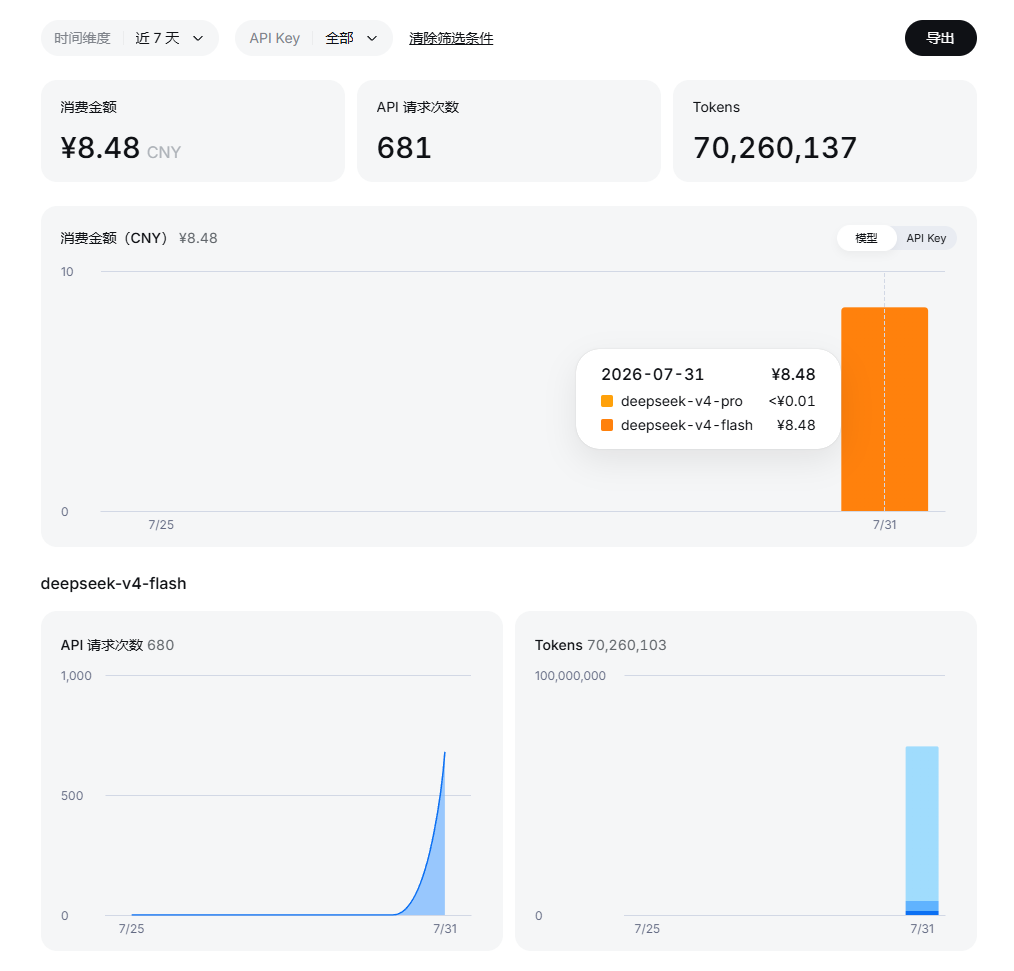 图 4:7 月 31 日一天,70M tokens,账单 8 块 4
账单拆开看:一整夜 681 次请求,Tokens 70,260,137,消费 ¥8.48,几乎全是 deepseek-v4-flash 一个模型烧的。这就是那一夜的全部成本。
账能这么低,不是牌价便宜这么简单。Claude Science 干活天然是海量输入、少量输出,读代码库、读报错、读数据全算输入;而它反复读的是同一批文件、同一段报错,大部分输入都吃到了缓存,命中价只有正常输入的 1/50。我以前算账一直看牌价,这次才发现牌价只是个入场券。
四、比便宜更要紧的是它不断
便宜本来是我最在意的,跑了几天发现不是。
真正改变工作方式的是它扛得住长跑。任务丢下去,我去睡觉,早上回来它还在跑。不掉线、不卡死、逻辑链没散。
只要 prompt 写清楚,它能自己滚:执行 → 报错 → 读报错 → 改 → 再执行。这个循环一旦能无人值守地转下去,成本结构就彻底变了。论聪明它排不到前面,论能连着干八个小时不出岔子,目前我只信它。
五、它是个瞎子
短板得说完。
没有视觉。 这是我踩得最疼的一条。让它调图,它看不见自己调出来的东西,只能照着代码猜。结果是越改越丑,而它自己毫不知情。
偶发乱码。 长上下文跑久了会吐出一小段乱码,不多,但出现在代码里就得回头查。
话多。 跑完同一套评测,它用了约 206M 输出 token,同类中位数是 100M,整整多一倍。每 token 便宜,但话多,纯输出密集的任务得重新算一遍。
前两条指向同一个解法:给它接一只眼睛。要么写一个带视觉反馈的 Skill,截图丢给有视觉的模型判好坏、再回灌给它;要么直接把视觉模型当端口挂上去,专管看。这事不难,但必须做。
六、脑贵手便宜,中间夹一层 review
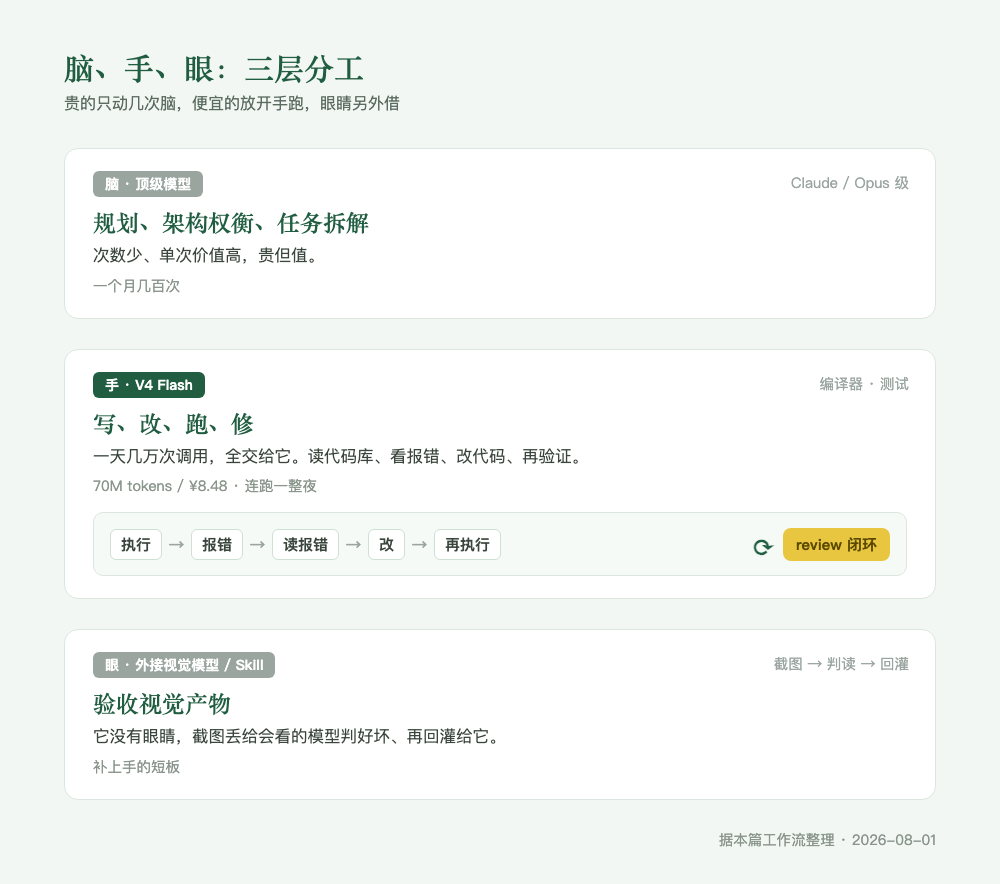 图 5:便宜的手,得配一只借来的眼
我现在的分层是三层。
- 脑: 规划、架构权衡、任务拆解。一个月几百次,用顶级模型,贵但值。
- 手: 写、改、跑、修。一天几万次调用,全交给 V4 Flash。
- 眼: 验收视觉产物。外接有视觉的模型或 Skill。
三层里最关键的一环是中间那道 review。Claude Code 那套带 review 的循环架构,跟它简直是天生一对:执行层疯狂试错,review 层负责拦,错了退回去重来。以前这种多跑几轮的打法舍不得用,一轮一轮全是钱;现在试错几乎免费,循环越深,省得越多。
把便宜发挥到极致的方式不是少花钱,是敢多跑几轮。
七、这套架构真跑出了什么
光说账单是空的。同一套分工,我在 Claude Science 里跑了一个完整的科研项目:DINOv3 + PatchCore 工业异常检测,数据处理、批量分析、报告生成都压在执行层上。
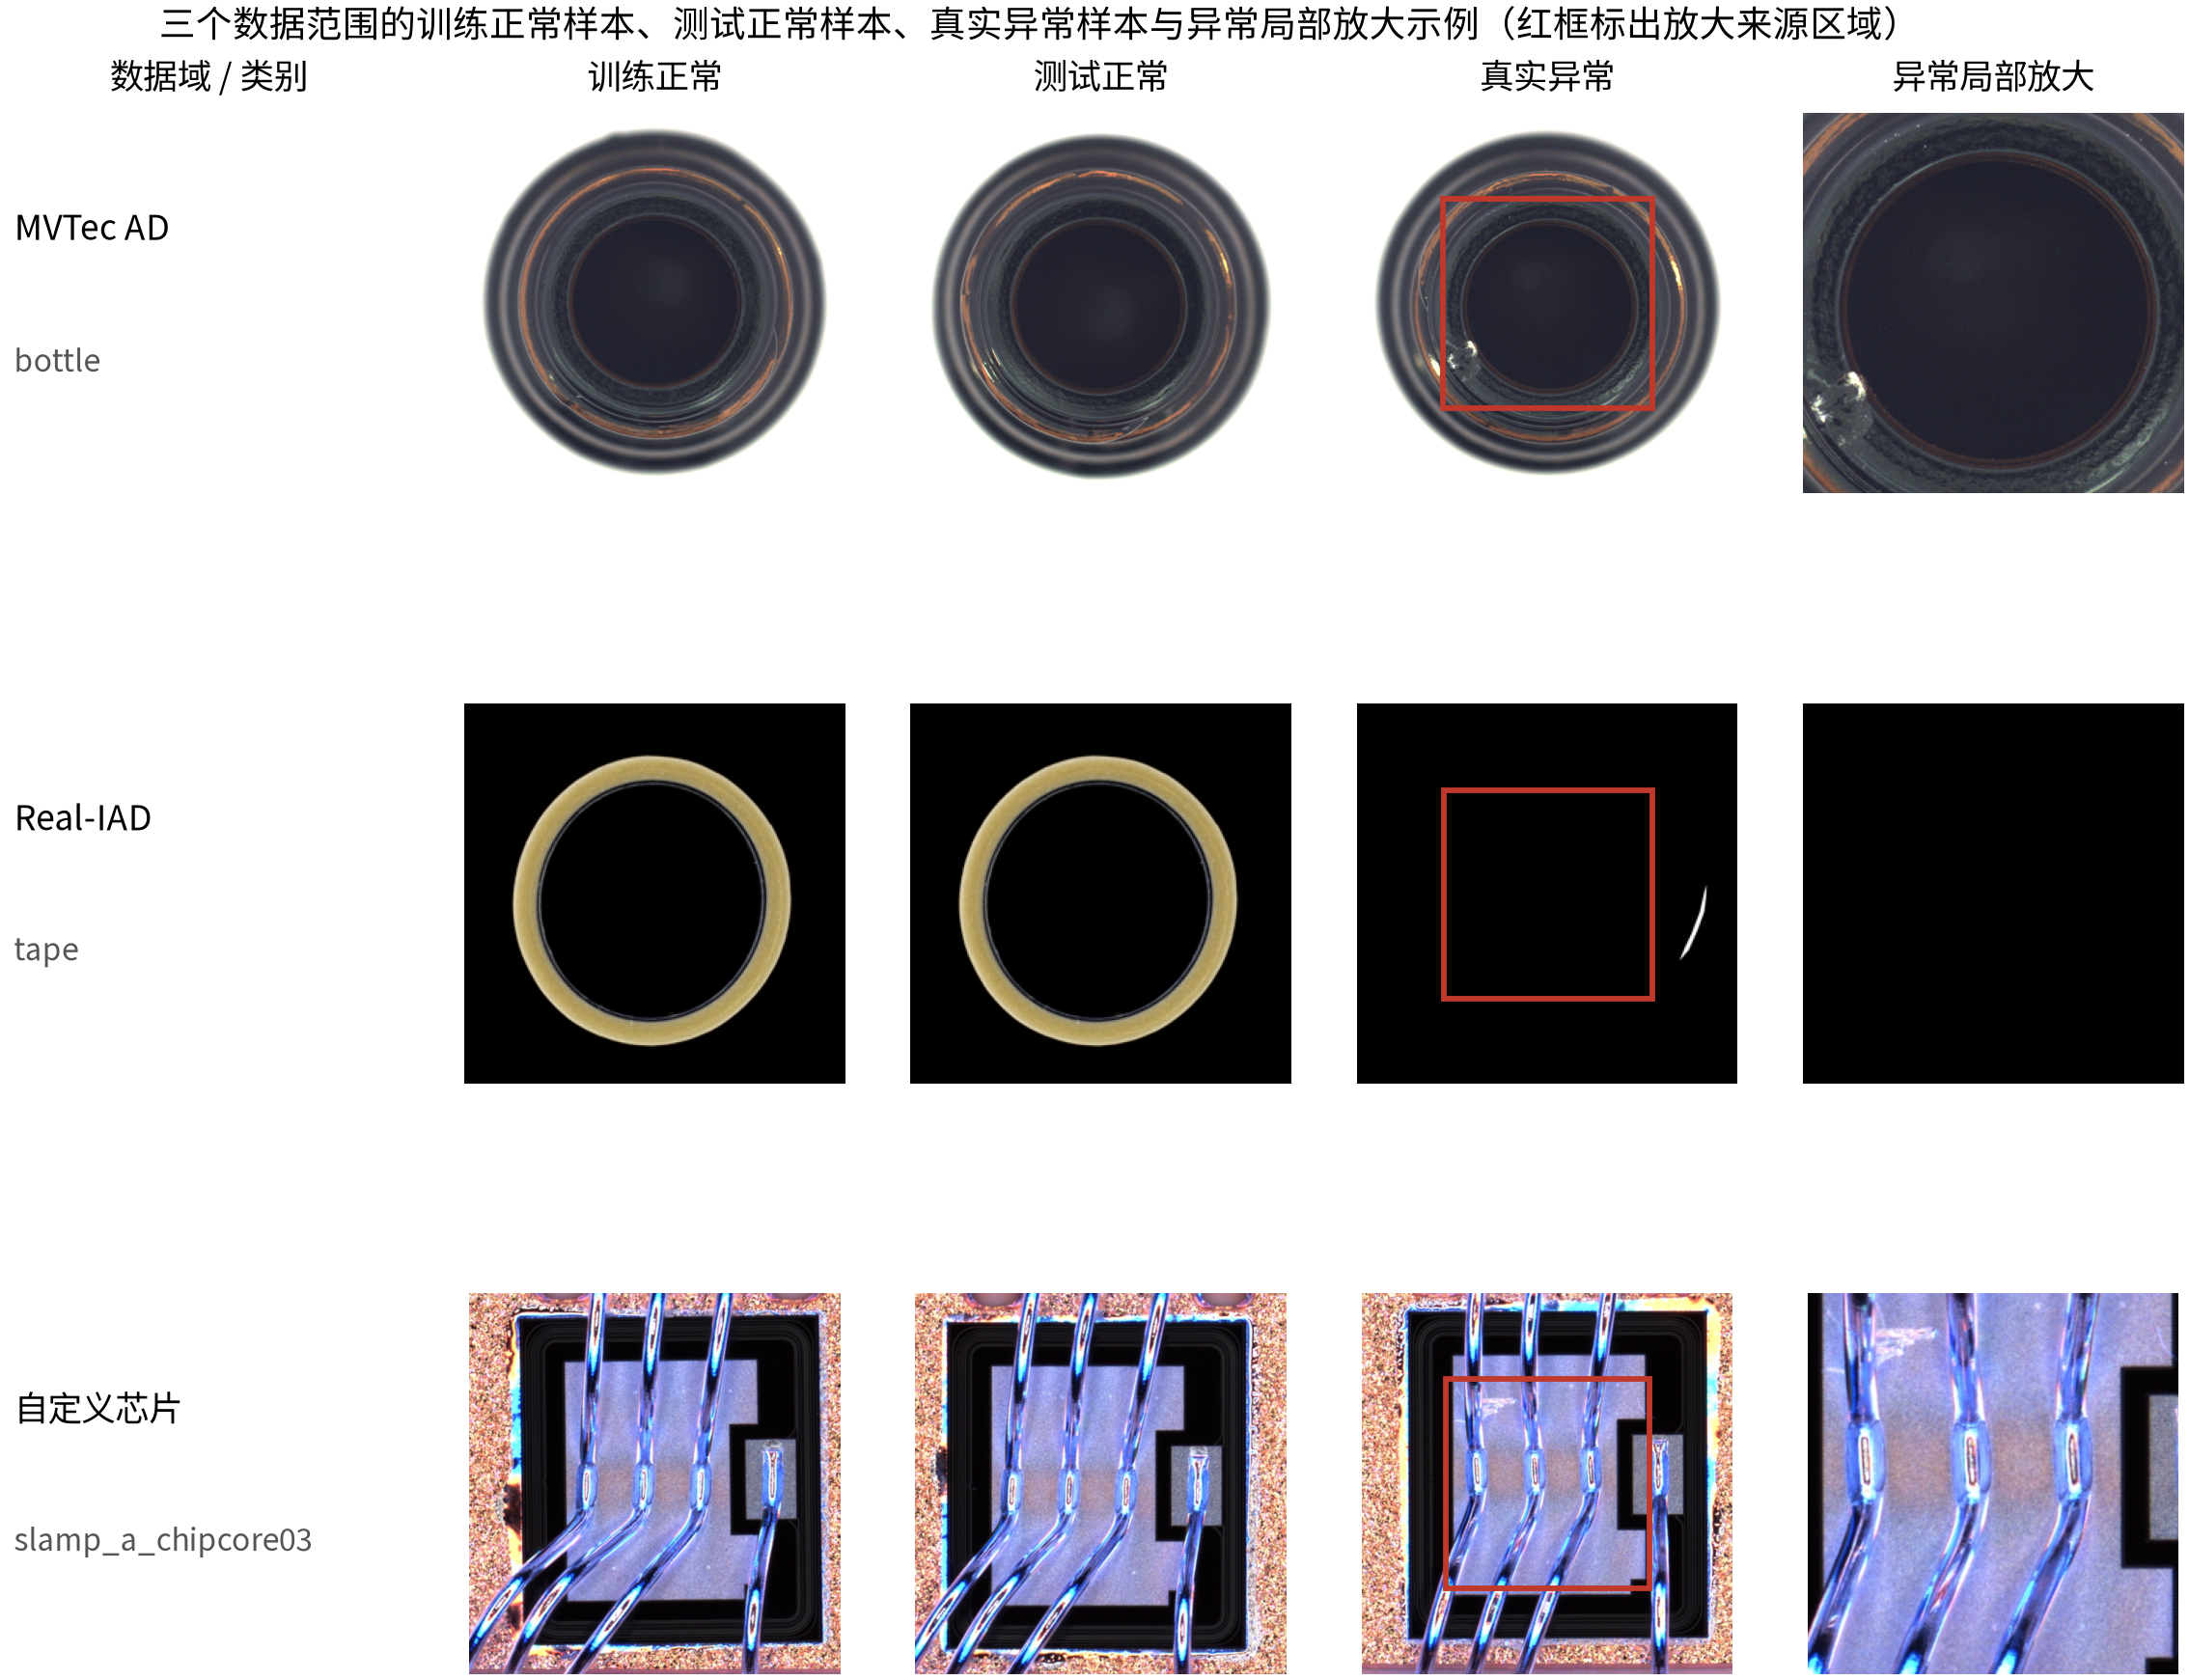 图 6:三个数据域,正常与真实异常并排
先看数据长什么样:bottle、tape、自定义芯片三个数据域,每个都给训练正常、测试正常、真实异常和局部放大。异常往往就是图里那一小块,肉眼不细看看不出来。
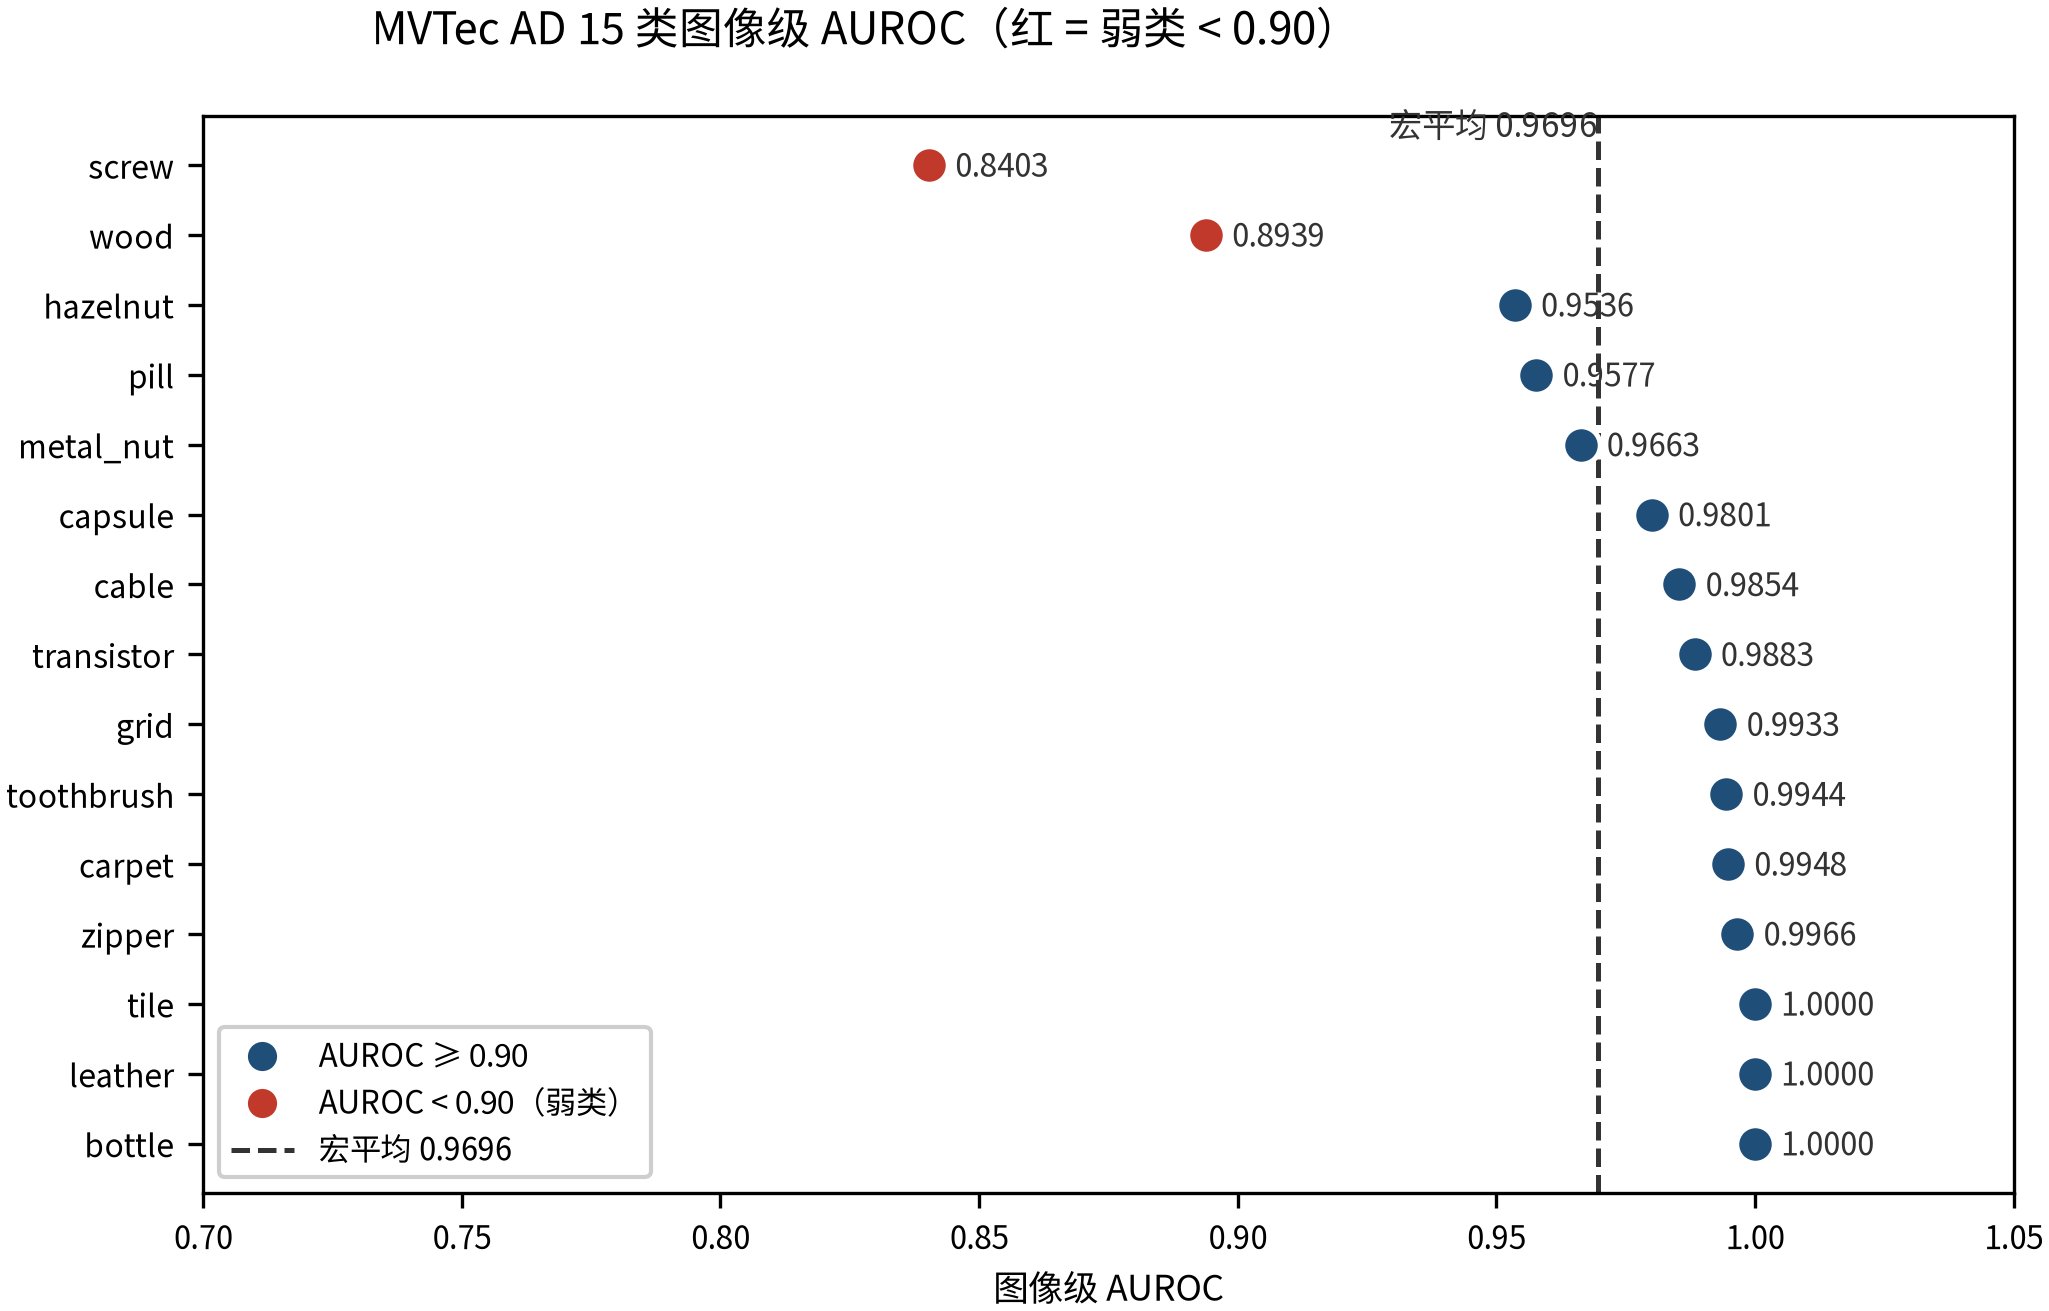 图 7:15 类里 13 类过 0.95
MVTec AD 15 类宏平均图像级 AUROC 0.9696。
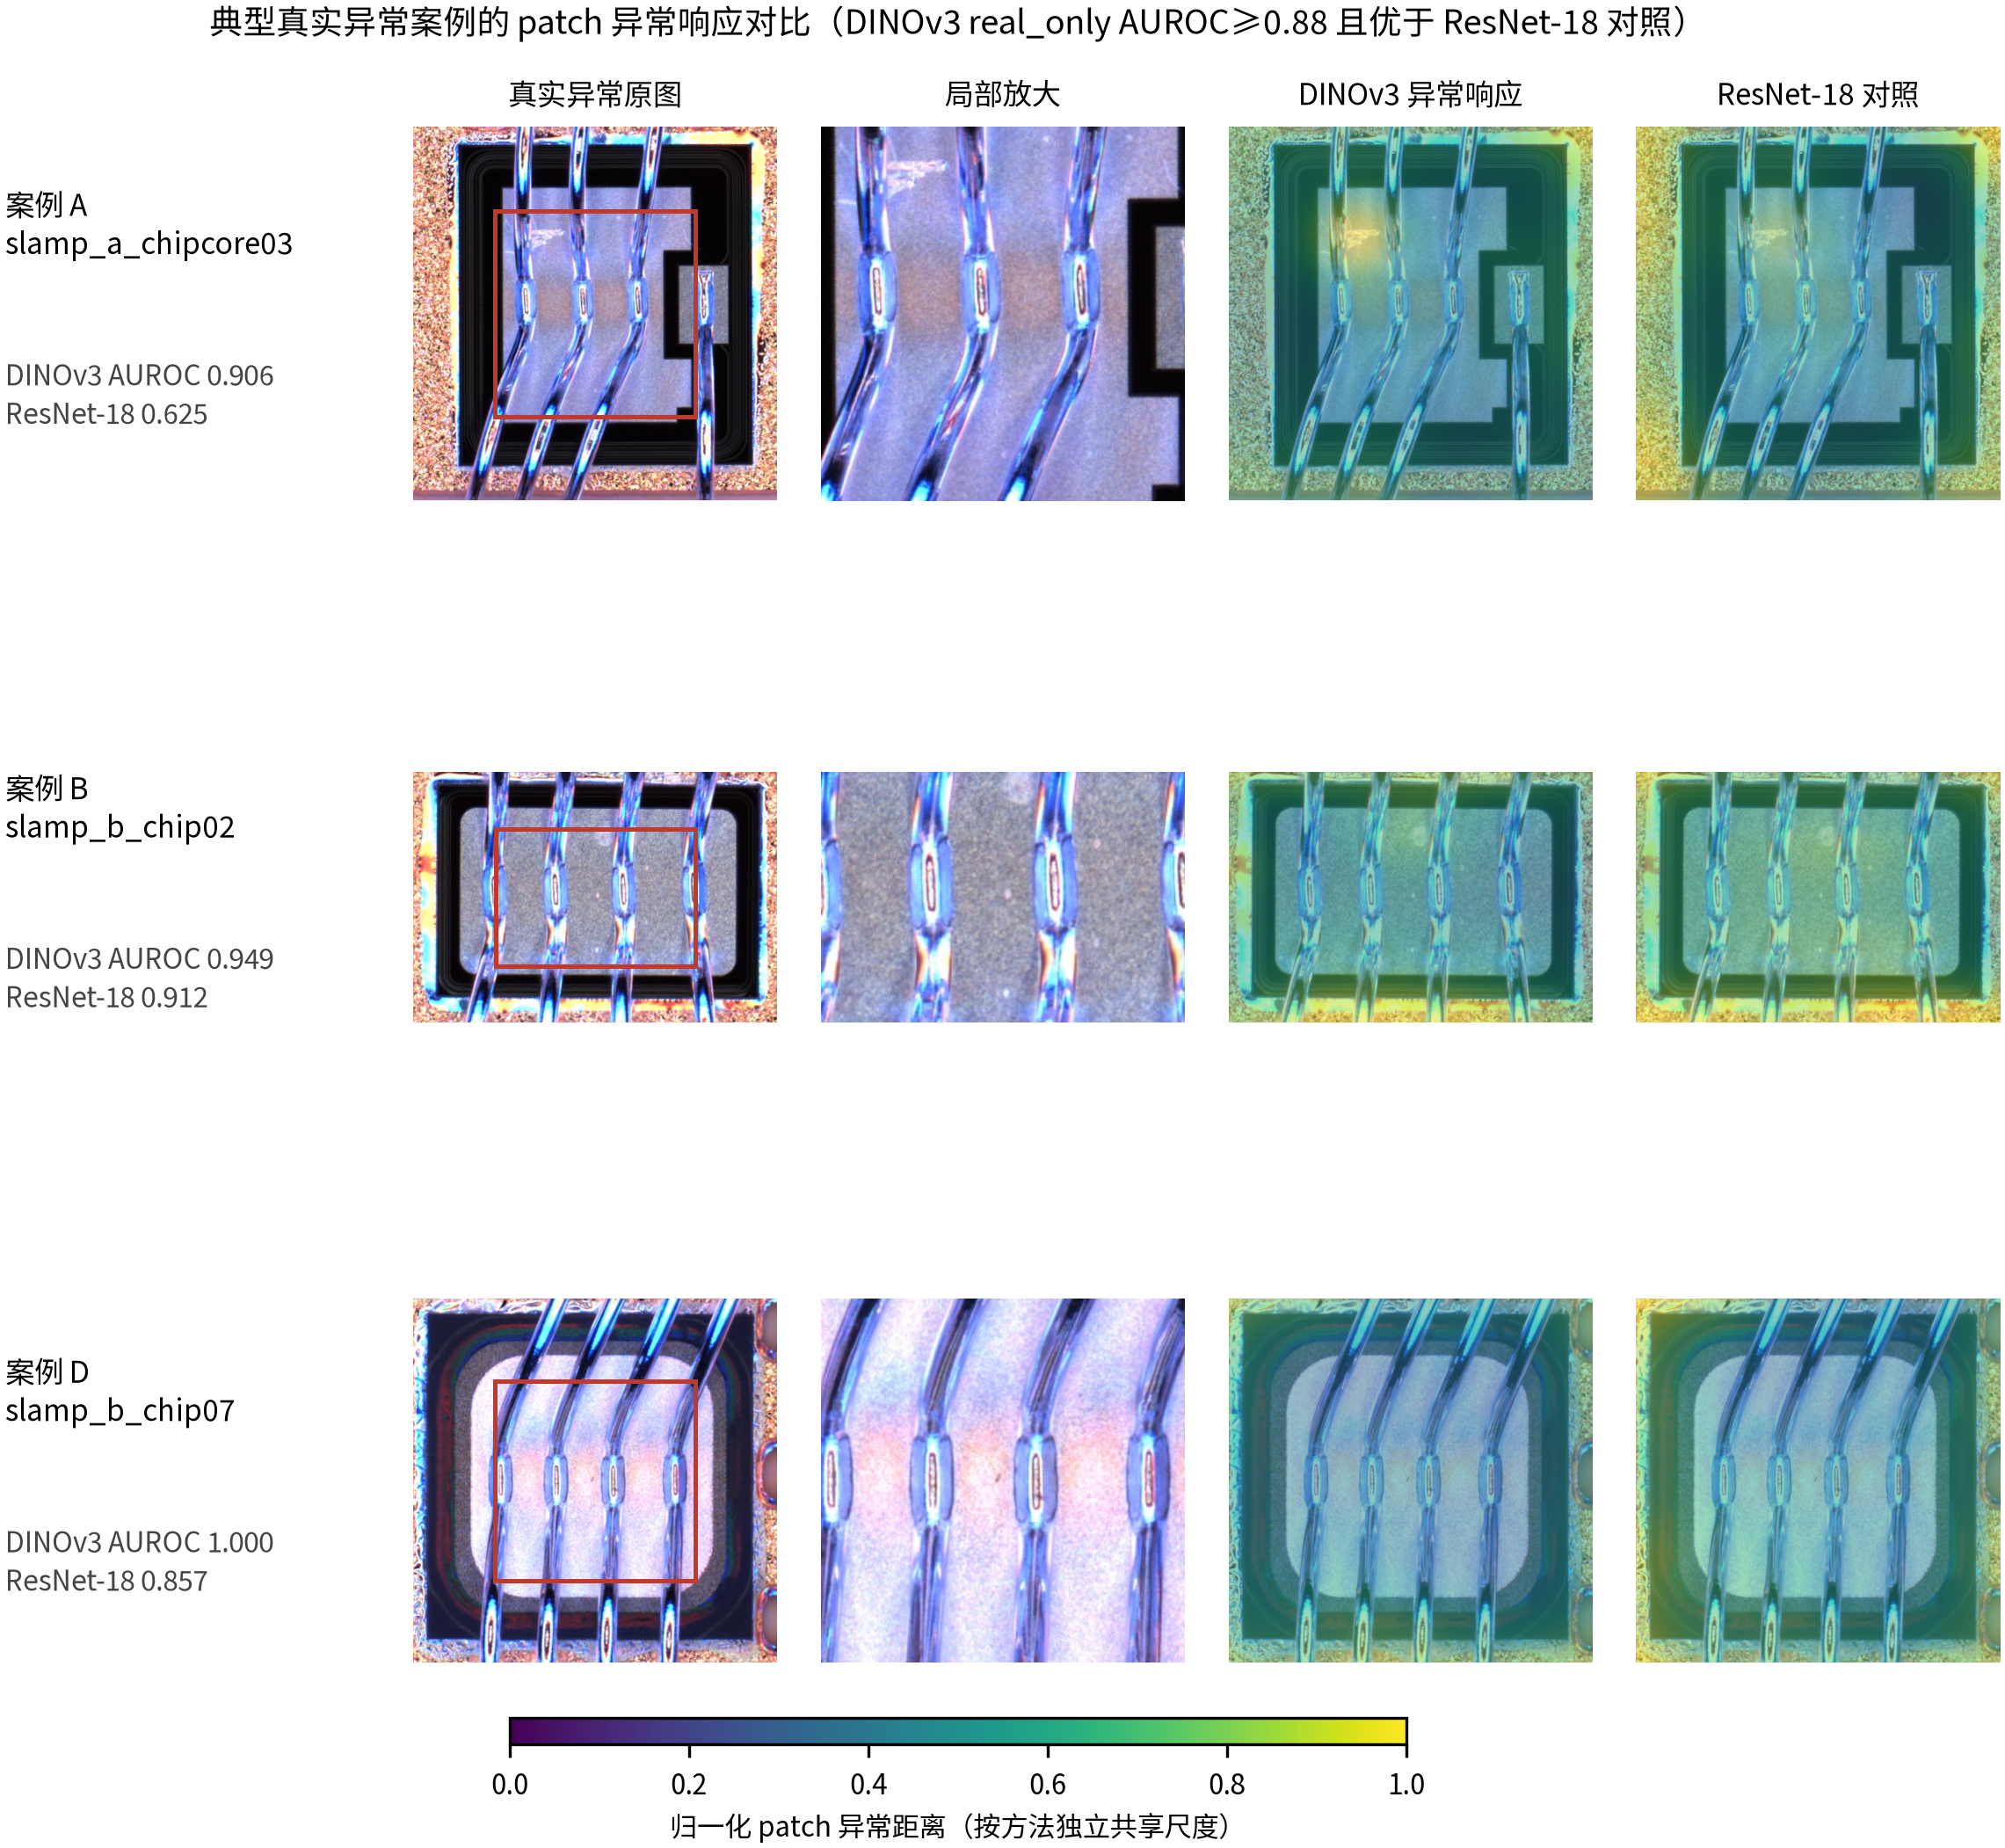 图 8:这几张的定位,你觉得准不准
这是几个真实缺陷样本的检测拼图,原图、标注、热力图并排。数字好看不算数,看图才知道它是不是真找对了地方。哪几张你觉得不行,评论区告诉我。
实验的假设、方法设计、结果判断都是我自己下的,Claude Science 干的是跑腿。省下来的是时间,不是判断。
总结:一张表带走
| 什么活 | 交给谁 | 数字 |
|---|---|---|
| 架构权衡、任务拆解 | 顶级模型(脑) | 一个月几百次 |
| 写码、改错、跑测试 | V4 Flash(手) | 70M tokens / ¥8.48 |
| 无人值守的长任务 | V4 Flash + review 闭环 | 连跑一整夜 |
| 看图、验收视觉产物 | 外接视觉模型或 Skill | 越改越丑 |
| 高重复上下文 | 吃缓存 | $0.0028 / 1M |
复盘:这一篇只在讲几件事
一层是价格。输出价落在顶级模型的百分之一档,这一条决定要不要试。
二层是结构。真正把账压下来的是缓存:命中价只有输入价的 1/50,它一个人把多出来的那一倍话抵掉了还有富余。
三层,说白了就一句:我改的不是模型,是分工。
现在我敢让 Claude Science 跑一整夜,第二天早上平静地看账单。
想更便宜地开始:我的邀请码
不想碰 API、只想要个现成壳子直接用的,走 OpenCode Go:首月 $5、次月 $10,里面的模型是一桌自助餐。
用我的邀请码注册,双方各返 $5,首月那 $5 基本等于没花出去:
- 邀请链接:
https://opencode.ai/go?ref=7ZWT70EQ03 - 邀请码:
7ZWT70EQ03
怎么挑模型、一天到底花多少,第 04 篇里写过,这里不重复。