09 · 疟疾红细胞分类:四步常规优化,召回率从 84% 爬到 96%
Claude Science 绿皮书 · 第 9 篇 · 2026-07-26
上一篇我说过,从那一篇开始往 CNN 走。这一篇兑现:疟疾红细胞分类。但我想走完的不只是一个 CNN,是一整条方法线,从最笨的 SVM,到从零训练的小 CNN,再到预训练的 EfficientNet,看指标怎么一步一步爬上去。
先说一个反直觉的结果。方法越复杂、来头越大,效果就越好——我一开始也是这么默认的。迁移学习(拿预训练好的网络来改造)我下了足功夫:拿预训练的 EfficientNet,冻结全部特征只训分类头,得了 94.83%。而一个从零搭的小 CNN,60 万参数,跑了 95.08%。力气花得更多,反而输给土法 0.25 个点。
排座次的从来不是复杂度,是合不合这批数据。
这个结果先搁着,看到第四节你就懂了。
为什么挑疟疾红细胞
先说这一篇和 07 的关系。07 那篇做乳腺癌,全程只用 SVM,力气都花在一个方法内部:挑参数、选核函数、做标准化,把这一套调到它自己的上限。这一篇换了打法:不再守着一个方法,横着换,SVM、CNN、预训练网络一个个试过去,看哪个对这批数据最合适。
说白了,07 练的是把一个方法调到上限,这一篇练的是在几个方法里挑出合适的那个。问题难了一级,就得换更合适的工具,而不是把手上这把用得更狠。
第一个真案例为什么选它,三个理由全是为教学。
- 数据够干净。 NIH 的公开数据集,27,558 张血涂片,感染和未感染各 13,779 张,正好对半。没有缺失要补,没有不均衡要处理,精力可以全花在方法本身。
- 图片本身就是证据。 07 那篇的乳腺癌是表格数据,得先解释 30 维特征每一维什么意思;这里图往那一放就明白:细胞里有一块染色斑点,就是感染了。给新手讲分类,省一半口舌。
- 串得起一整条方法演进。 SVM 手工做特征、CNN 端到端(从原图一步出答案)、迁移学习借现成网络,这三步几乎是图像分类的全部入门选项。一套数据走完,方法怎么完善的就看清了。
还有一层领域背景:筛查里漏掉一个感染细胞,远比误报一个正常细胞严重。这直接决定了我全程盯着召回率(真感染里被抓出来的比例)和漏报数,而不是只看准确率。
不想读完?先记这四条
- 想复现:NIH 公开数据集,27,558 张图,下载就能跑
- 想选方法:SVM 到 CNN 跳得最狠,召回率一次上 10 个点
- 想迁移学习:冻结不够,必须微调,不然打不过从零的小 CNN
- 想公平对比:四步跑在同一份划分上,并给划分文件算一串指纹码,不然差距一半是幻觉
一、27,558 张图,两类正好对半
先看数据。NIH 的疟疾细胞数据集,一共 27,558 张血涂片图,感染和未感染各 13,779 张。这个「正好对半」在医学图像里难得,不用自己去做类别平衡。
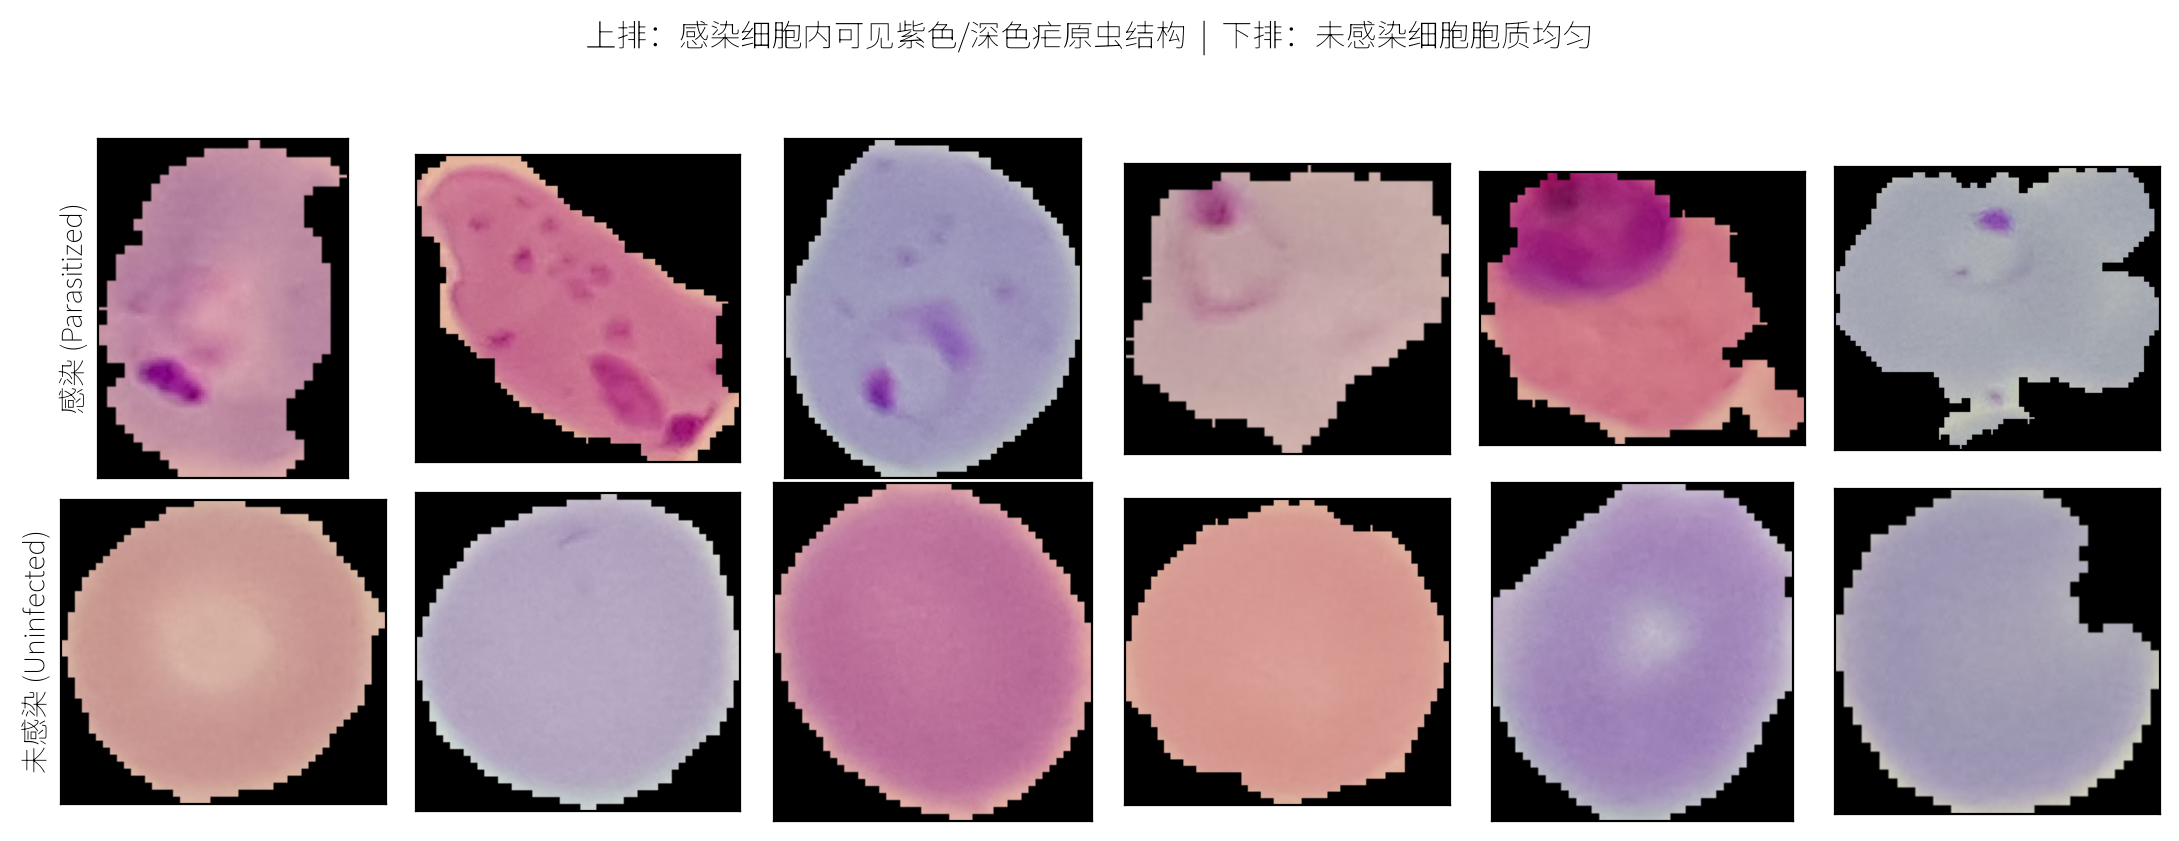 图 1:样本:细胞内部的染色斑点是证据
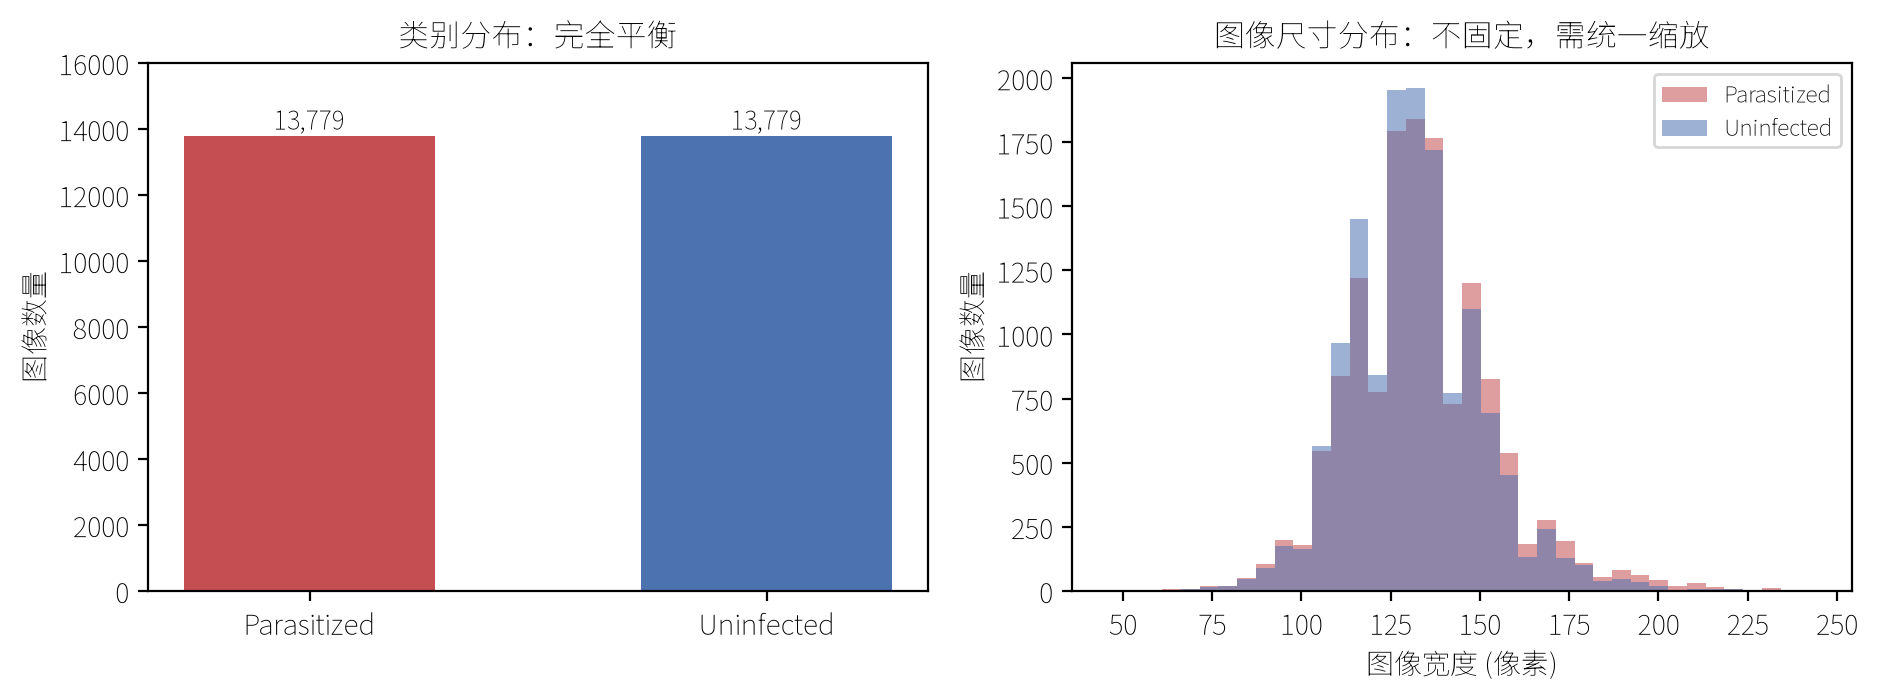 图 2:尺寸:宽度中位 130 像素,大小悬殊
看样本图:两类细胞大小形状都差不多,区别在内部,感染细胞里有疟原虫留下的紫色斑点。人靠分辨这一小块颜色,我后面喂给 SVM 的,也是这类颜色的统计量。尺寸分布则大小悬殊:宽度中位数 130 像素,最小 46,最大 394。这决定了预处理里统一缩放这一步省不掉。
二、先跑经典方法:63 维手工特征考 88 分
第一个方法,走最经典的那一路:SVM(支持向量机,一种经典的老式分类器)。它看不了图,我得先亲手把图翻译成数字:RGB 颜色直方图 48 维,RGB 均值方差 6 维,HSV(换一种方式描述颜色)均值方差 6 维,灰度纹理 3 维,凑成 63 维。再做标准化(把各维数字拉到同一量级),核函数用 RBF(一种衡量样本间相似度的算法),强度参数 C=1.0。传统机器学习的经典套路:特征全靠人设计,模型只负责最后一步分类。
结果:准确率 88.27%。还行?看混淆矩阵(一张「谁被认对、谁被认错」的统计表)。
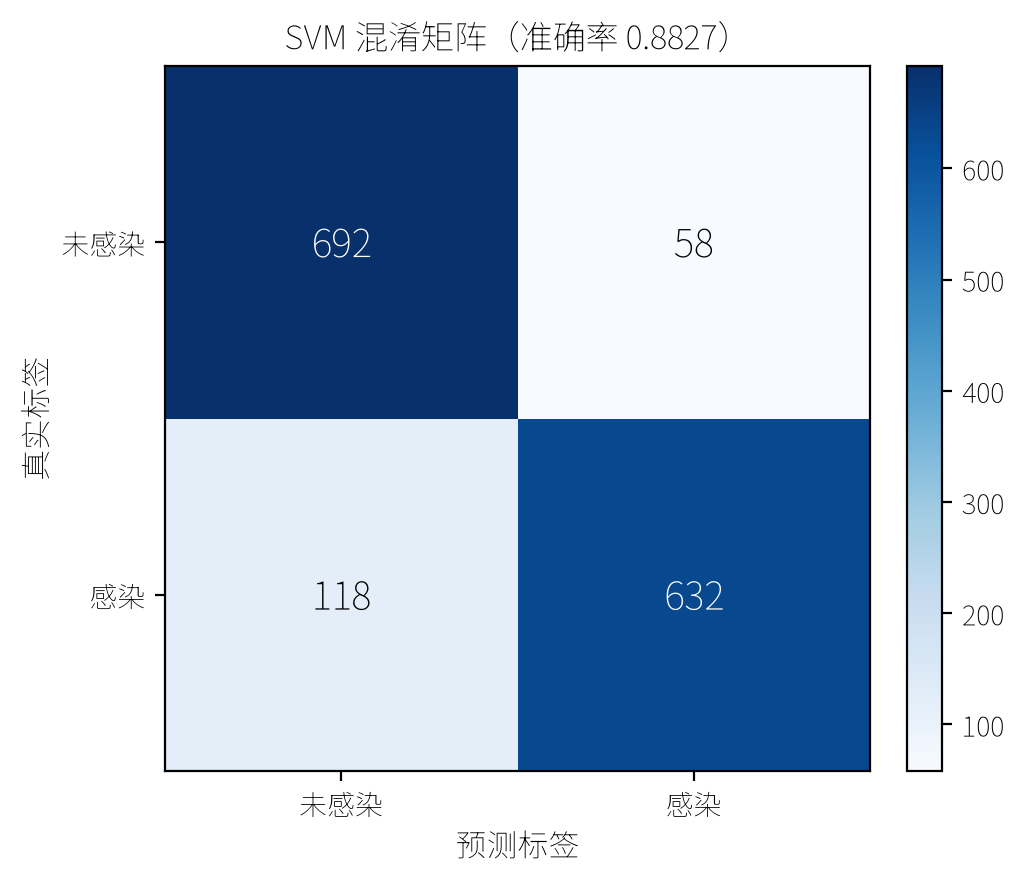 图 3:SVM 混淆矩阵:118 个感染被漏掉
1,500 张测试图里,118 个真感染被漏掉(假阴性),58 个未感染被误报(假阳性)。SVM 的问题也很明显:那 63 维特征是我拍死的定值,颜色差多大、纹理看哪种,全凭我猜,模型自己学不到任何新的看法。
我故意先跑这个最简单的,因为它就是后面那把尺子:后面每换一次方法,提升都拿这个 88.27 来量。没有基线,你根本不知道方法是好是坏,只知道它看起来高不高级。
三、换一步:不手工做特征了,让卷积自己学
第二个方法:简单 CNN(卷积神经网络)。只改一件事,不再手工做特征,直接把原始图片喂进去,让网络自己学特征。所谓卷积,就是拿一个个小窗口扫过全图,自己学该盯哪块。
网络不大:三个卷积块,每块的小窗口数(通道数)分别是 16、32、64,每块做同一套动作:扫图、归一、筛信号、压尺寸。图片统一缩放到 96×96,末尾再加一层 Dropout 0.3(训练时随机关掉三成神经元,防死记硬背),总参数 613,761。优化器用 Adam(会自动调节步幅的算法),学习率(每步调多大)1e-3,数据增强就水平垂直翻转加 15 度旋转,训 12 轮。这份数据切出训练 5,600 张、验证 1,200 张、测试 1,200 张,EfficientNet 后面走的同一份。全程跑在我的本地 CPU 上,没用 GPU。
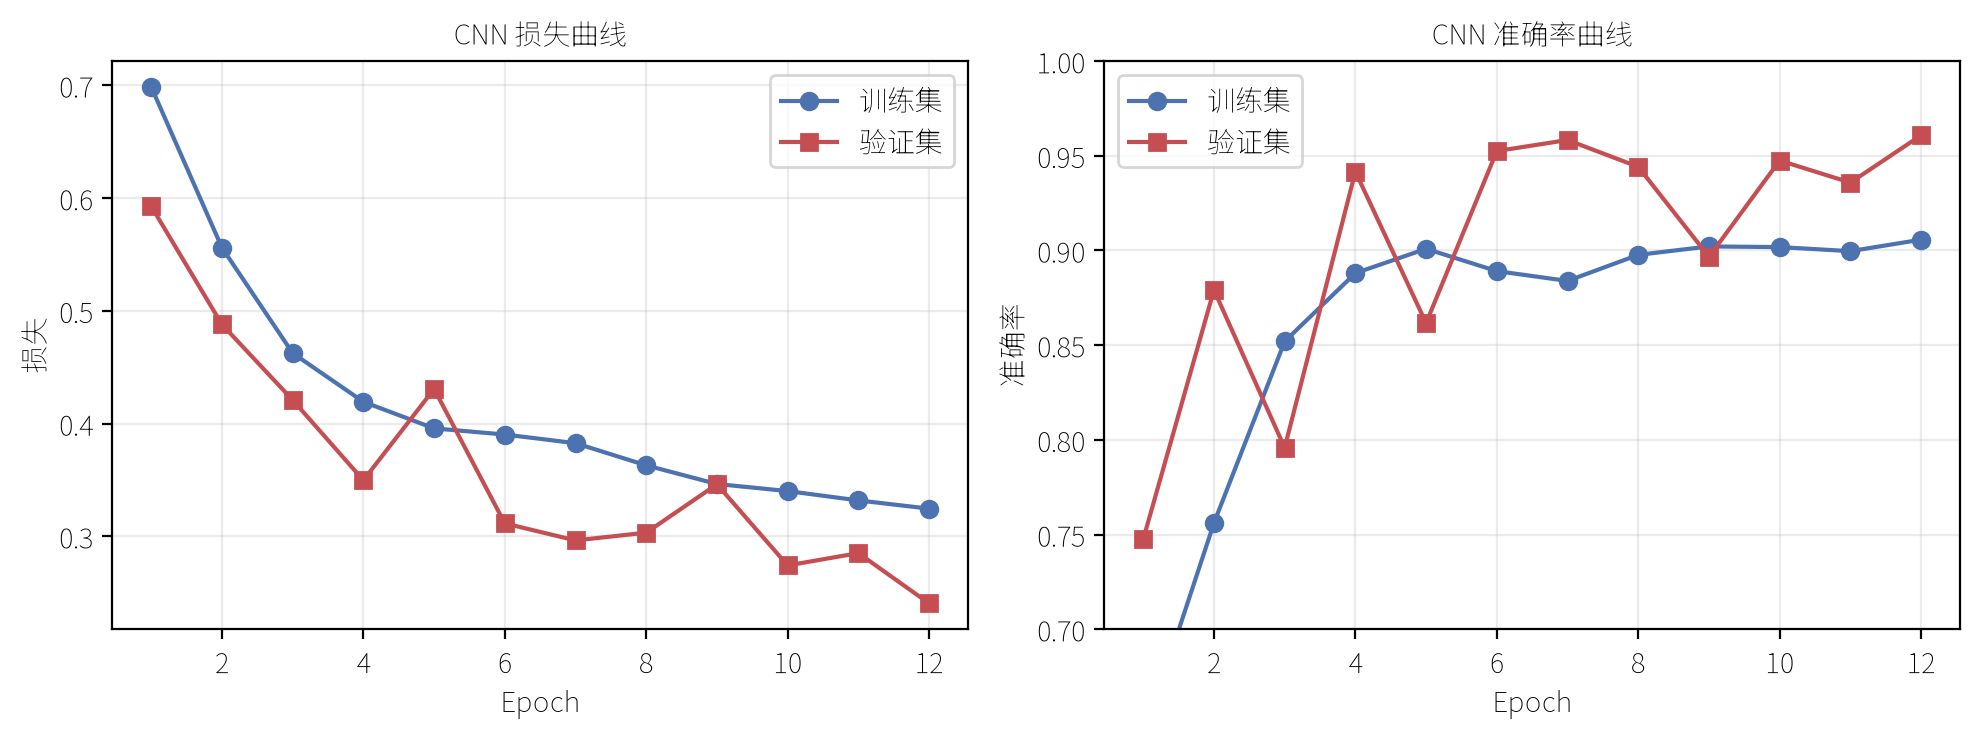 图 4:训练曲线:12 轮跑稳,没翻车
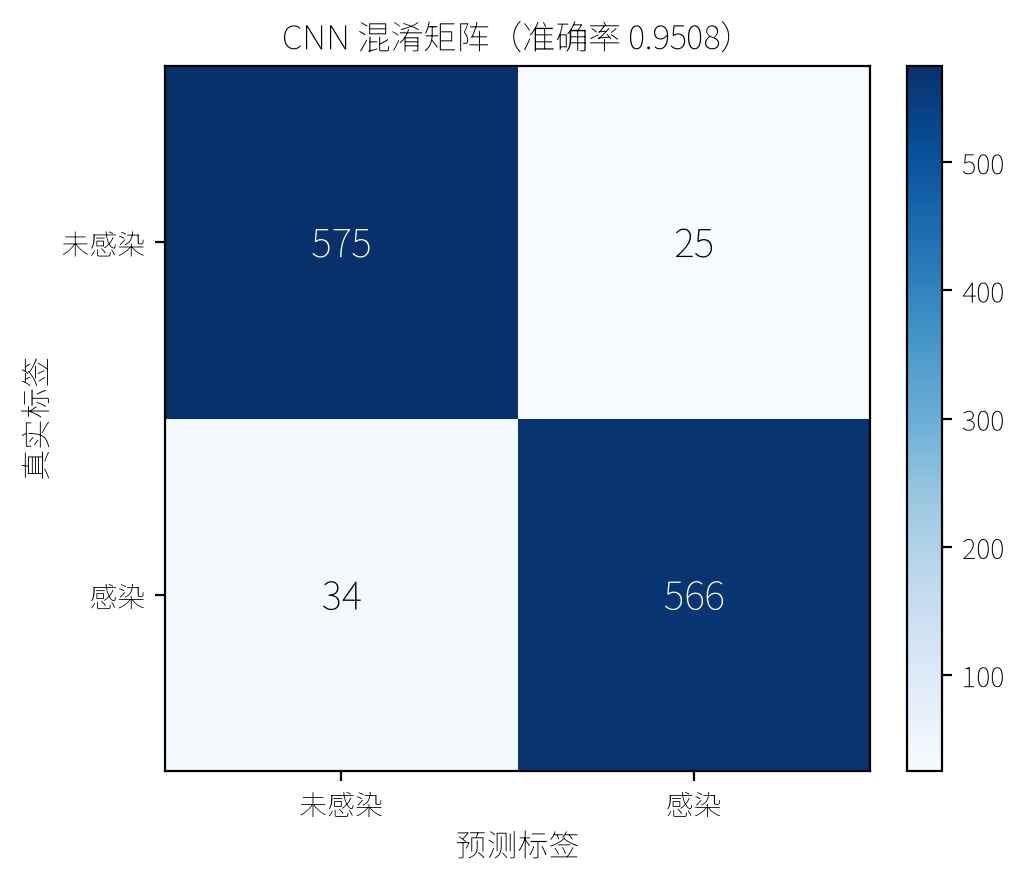 图 5:CNN 混淆矩阵:漏报从 118 降到 34
准确率 95.08%,感染召回率从 84.27 跳到 94.33,漏报从 118 降到 34,直接砍掉七成多。这一下的跨度也最大。道理也简单:对这种图,特征怎么来,比分类器多高级更要紧。我给 SVM 的那 63 维特征,等于亲手把空间信息全扔了,斑点在哪、什么形状、和周围什么关系,卷积网络用自己学出来的卷积核全接住了,而我只给过它颜色统计。
把这一步和上一步摆在一起看,其实是两条路线在对撞。传统机器学习那一条,特征由人设计,模型只管最后一步分类,上限卡在设计特征的人身上;深度学习那一条,特征和分类一起学,图直接进去、答案直接出来。这批细胞恰好是后者的主场:证据是那一小块染色的形状、位置和周围关系,这些东西写不成 63 个数。换过来的代价不过是多跑了 12 轮 CPU,换来的是准确率从 88.27 抬到 95.08,感染召回率从 84.27 抬到 94.33,一次上 10 个点。这是全程唯一一次上双位数。
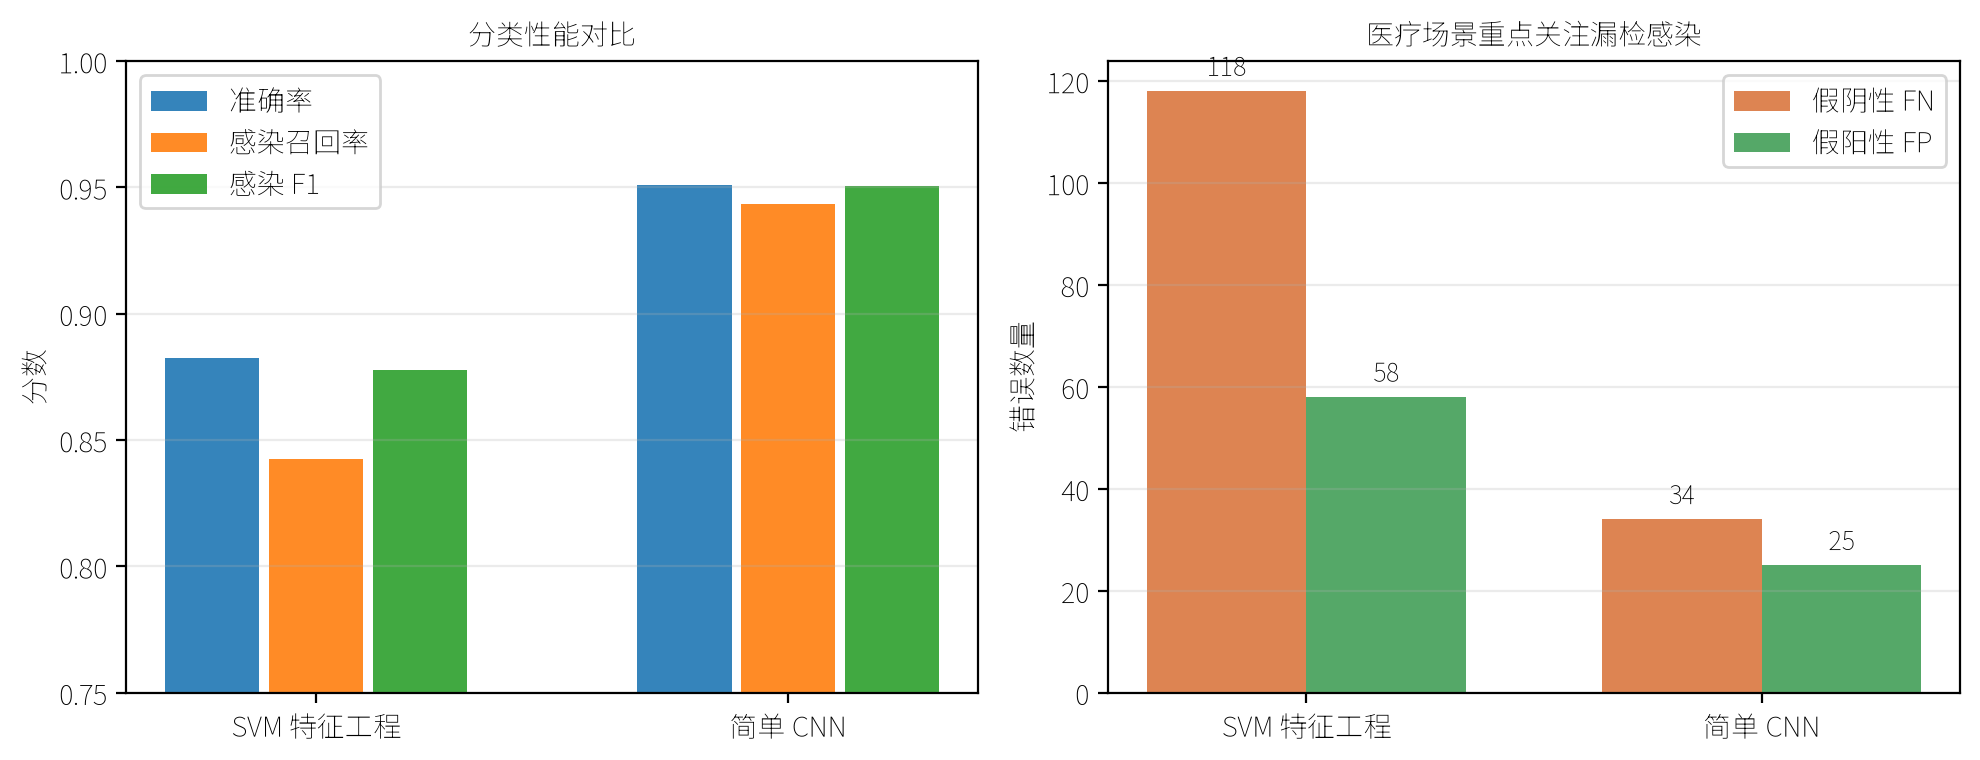 图 6:两步跳跃:SVM 到 CNN 跨度最大
四、再进一步:预训练 EfficientNet,冻结版反而不行
第三个方法:迁移学习。我用的是 EfficientNet-B0,一个现成的图像识别网络,B0 是它最小的型号;它已在 ImageNet 这个大型日常物体图集上预训练过,我把它的最后一层换成二分类。我跑了两个版本,差距就是全文最反直觉的地方。
冻结版:冻住全部卷积层,不让预训练经验动一分一毫,只训练最后的判断层(分类头),学习率 1e-3,3 轮。结果 94.83%,比从零训练的小 CNN 的 95.08% 还低。白忙活一天。为什么?ImageNet 装的是猫狗汽车,它练出来的是「怎么认日常物体」;血涂片细胞里那一小块染色斑点,完全在它的经验之外,这道坎叫 domain gap。冻结的头只能拿别人的旧眼镜看新细胞,当然对不上。
微调版:解冻最后三个卷积块,和分类头一起训,小学习率 1e-4,再训 8 轮。这回 96.50%,召回率 95.17%,漏报 29,误报只有 13。为了给筛查再多抠一点召回,我又把判定阈值(判感染还是正常的分界线)从 0.5 挪到 0.325:召回率升到 96.00%,漏报 29 降到 24,代价是误报 13 涨到 17。多救 5 个,多冤枉 4 个,在筛查逻辑里这笔账划算。
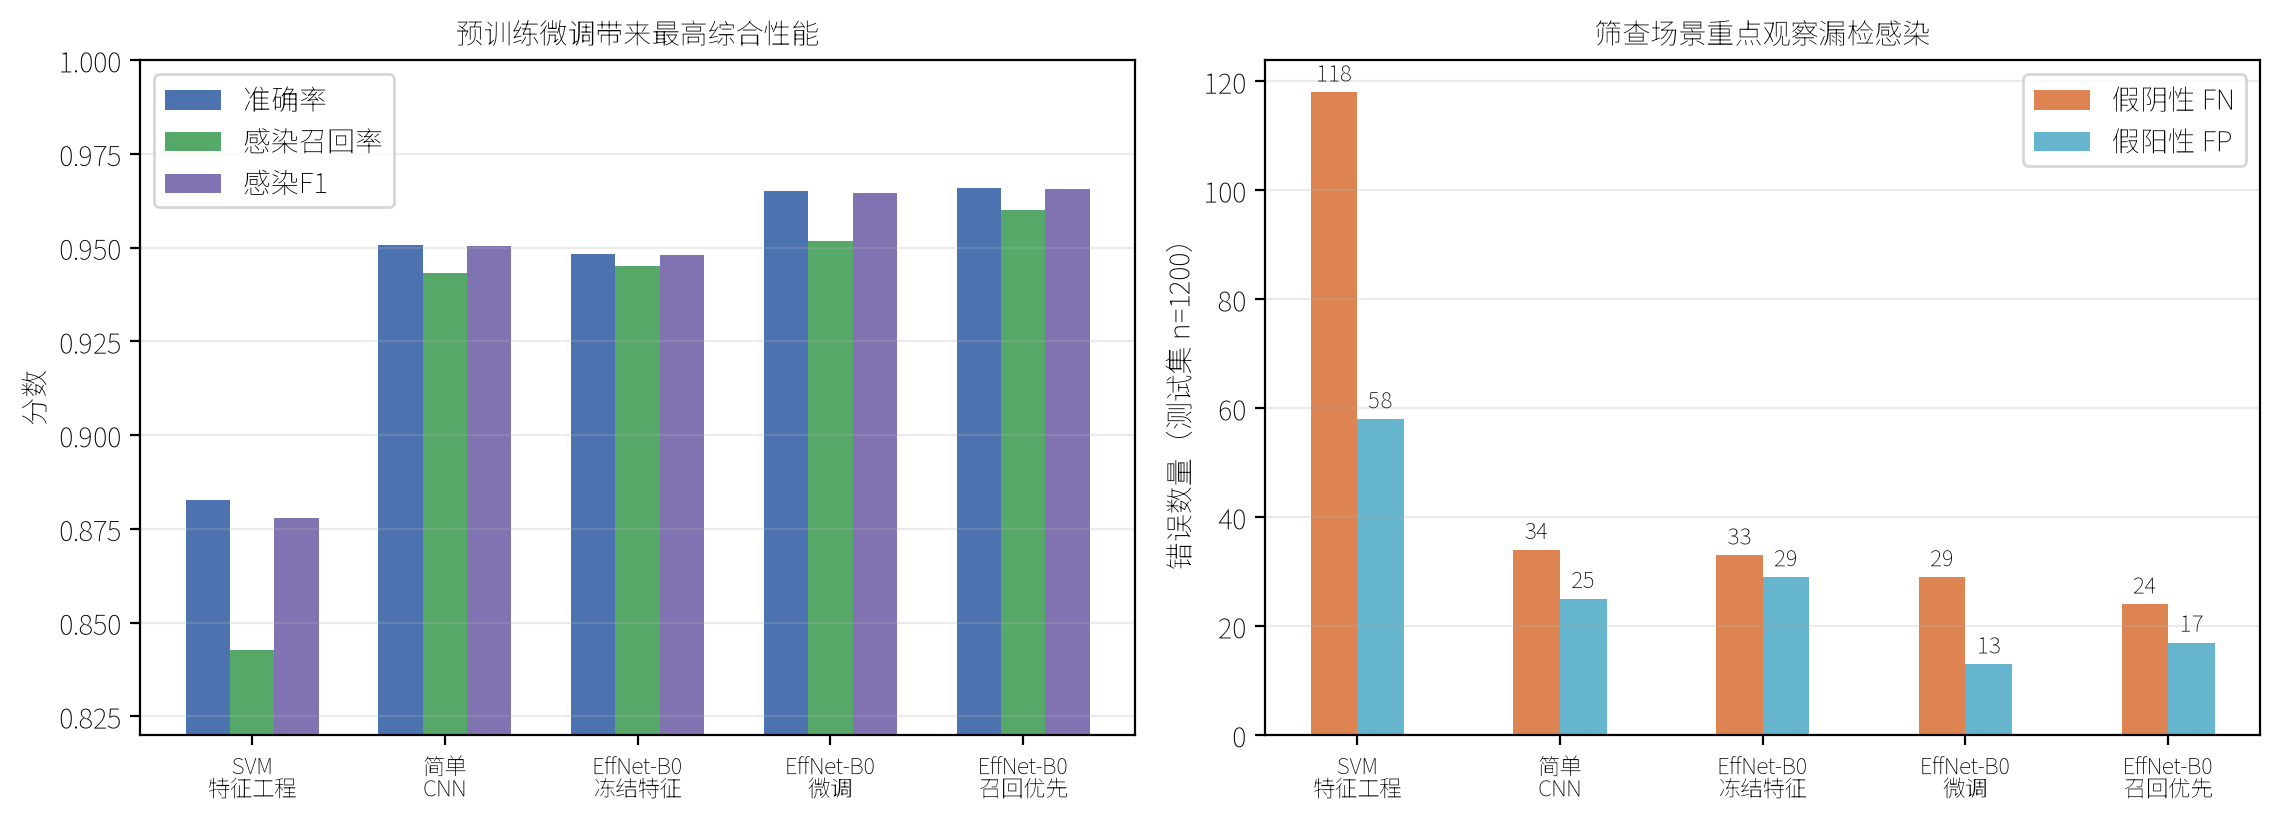 图 7:四版对比:微调版站到了最高
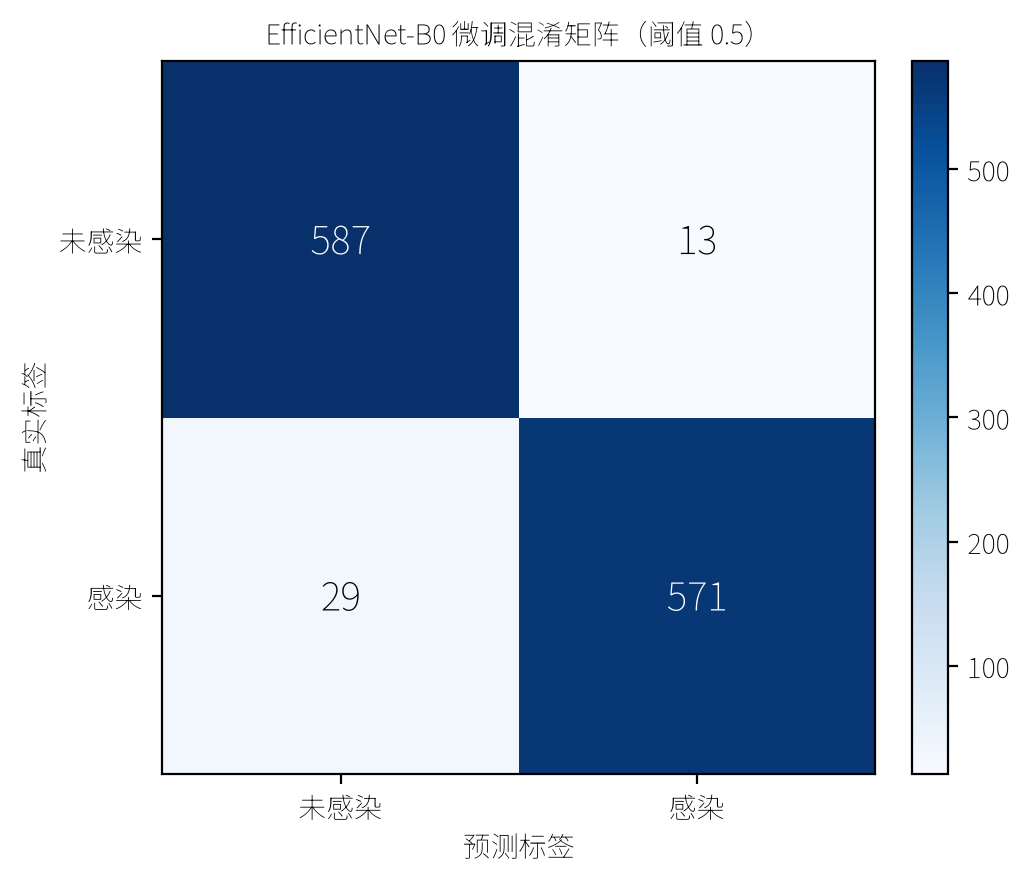 图 8:微调混淆矩阵:1,200 张里面对 1,158
到这里,开头那个结果也就有了答案:预训练表征是好东西,但得微调才弯得到这个领域。
上一节那张图把第一步的跨度画出来了。再比一次。上一步从手工特征换成卷积,准确率一次抬了 6.81 个点;这一步从自己搭的小 CNN 换成微调过的大网络,只抬了 1.42,感染召回率从 94.33 到 95.17,不到 1 个点。换路线那一下挣到的是大头,后面换更大的网络只剩零点几。越往后能抠出来的越薄,这也是我在这里停手、转去动阈值,而不是继续找更大模型的原因。
五、把整个过程串一遍
四步走到这里算走完了:先跑经典的 SVM 当尺子,换成自己学特征的 CNN,再换来头更大的预训练网络,最后把这个大网络微调到自己这批数据上。每一步只动一个地方,动完量一次,量完再定下一步动哪里。
数字上就是从 88 分起步,一步抬到 95,后面两步一点点磨到 96.5,漏报从 118 个降到 24 个。我没在哪一步发明新东西,用的全是现成的。难的只有两件:按顺序做完,每一步都留下能对账的数字。
只有一件事得留到下一节:这四步并不全跑在同一批测试题上。所以两个数字之间的差,先得看是不是同一批题,绝对不能直接相减就下结论。
六、回头审一遍:数字差点立不住
这一篇最大的坑不在模型训练,在「数字立不住」。
先是划分的事。SVM 先跑,当时随手用自己的划分;CNN 后跑,又换了一份。对比时我才反应过来:两组数字是在不同测试集上测的,差距里有一半是幻觉,也许方法强,也许只是那批测试题恰好简单。补救办法很笨但管用:把这份划分写进一个文件定死,再给这个文件算一串指纹码(学术上叫哈希校验和,这里用 SHA256;内容动一个字节都能发现)。后面在远端跑的时候必须带上这份文件,指纹对不上就直接报错。从此 CNN 95.08 对微调 96.50 这 1.42 个点,是同一批题上的真差距。
再是我抄错过自己的数字。EfficientNet 微调的漏报数,早期稿里写成 16,实际是 29,一整列混淆矩阵跟着抄歪,是第三轮审计逐条对原始输出才对出来的。还有参考文献:一度有 6 条没核验就写进了稿子,后来又混进来一条没核过的引用,分两轮才清空。自己跑出来的不等于可信,每个数都得能回溯到原始输出。
七、想自己跑一遍:把这段话丢给助手
上面这四步不靠手气,靠的是顺序。想自己跑一遍,把下面这段直接丢给你的 AI 助手就行,不用自己想流程。
我要做一个血涂片细胞图的二分类,数据用 NIH 公开的那份(27,558 张,两类各一半)。
按下面的步骤做,一步一步来,每做完一步先把结果给我看,我说继续你再做下一步。

0、先切一份划分并定死:训练 5,600、验证 1,200、测试 1,200。切完写进一个文件,给文件算一串指纹码。后面每一步都用这一份,不许重切。
1、第一步跑经典方法、做基线:手工提颜色和纹理特征(RGB 直方图、均值方差、HSV、灰度纹理,一共 63 维),标准化后用 SVM 分类。给我四个数:准确率、感染召回率、漏报数、误报数,加一张混淆矩阵。
2、第二步换从零训练的小卷积网络:三个卷积块(16/32/64),图缩到 96×96,加一层 Dropout 0.3,Adam,学习率 1e-3,训 12 轮。同样四个数加混淆矩阵,并与第一步并排放。
3、第三步换预训练的 EfficientNet-B0:先冻住全部卷积层、只训分类头,学习率 1e-3 训 3 轮;再解冻最后三个卷积块一起训,学习率 1e-4 训 8 轮。两版都给四个数。
4、最后调判定阈值:以感染召回率为主,找一个漏报更少的阈值,把代价(误报涨了多少)一并报给我。

四条规矩:
- 每一步只改一个地方,改完量一次。
- 每一个数字都要能回溯到原始输出,不准转述。
- 四步必须跑在同一份划分上。
- 不要预设哪个方法更强,也不要替我下结论。后一步比前一步差也是结果,照实报。
这段话里没有一句是技巧,全是约束:一步一步做、一次只改一处、数字要能对账。最后一条最容易被省:别先告诉它哪个方法更强。你要是开口就说“先跑个差的”,它就会朝这个结论去写结果,比完也就不算比了。此前那两次让我意外的结果(冻结版输给小网络、预训练并不自动更强),正好是因为没预设才看得到。
总结:一张表带走
全文的数字,我压进了这张表:
| 方法 | 换了什么 | 准确率 | 感染召回 | 漏报 FN | 一句 takeaway |
|---|---|---|---|---|---|
| SVM 特征工程 | 手工 63 维特征 | 88.27% | 84.27% | 118 | 基线,尺子 |
| 简单 CNN | 卷积自己学特征 | 95.08% | 94.33% | 34 | 最大的跳,来自自动学特征 |
| EfficientNet-B0 冻结 | 只训预训练的头 | 94.83% | 94.50% | 33 | 冻着用,打不过从零 |
| EfficientNet-B0 微调 | 解冻后三个块 | 96.50% | 95.17% | 29 | 微调才跨过 domain gap |
| 微调 + 召回阈值 | 阈值 0.5→0.325 | 96.58% | 96.00% | 24 | 筛查宁可多报,不可漏 |
复盘:提升到底从哪来
回头看,这四步只回答一个问题:提升到底从哪来。
先算总账:漏报的感染细胞,从 SVM 的 118 个,一路降到最后的 24 个。四步走下来,多抓回 94 个。
但这 94 个不是匀着来的。从 SVM 到 CNN,分类器不过从核函数换成卷积层,真正变的是特征不再由我手工设计,改成网络自己从图里学:漏报从 118 一次降到 34,一步抓回 84 个,占尽大头。从 CNN 到预训练微调,模型更大、来头更响,漏报只从 34 降到 29;最后把判定阈值往召回那边挪了挪,又救回 5 个,才凑到 24。后两步加起来,不过 10 个。
所以这笔账很清楚:大头在“不再手工做特征”这一步就挣完了,后两步是在这个底子上一点点收窄误差。整条路没有一个新方法,全是现成的常规操作,只是按顺序做完了、没有跳步。
一句带走
这一路没有一个新方法,全是现成的:先跑经典方法当尺子,换成 CNN,再换更大的预训练网络,最后把这个大网络微调到自己这批数据上。四步,每步只动一个地方。
真正把 96.5 抠出来的,不是哪个模型更强,是最后那一步:把一个通用的大网络,一点点搬到自己这批细胞上。
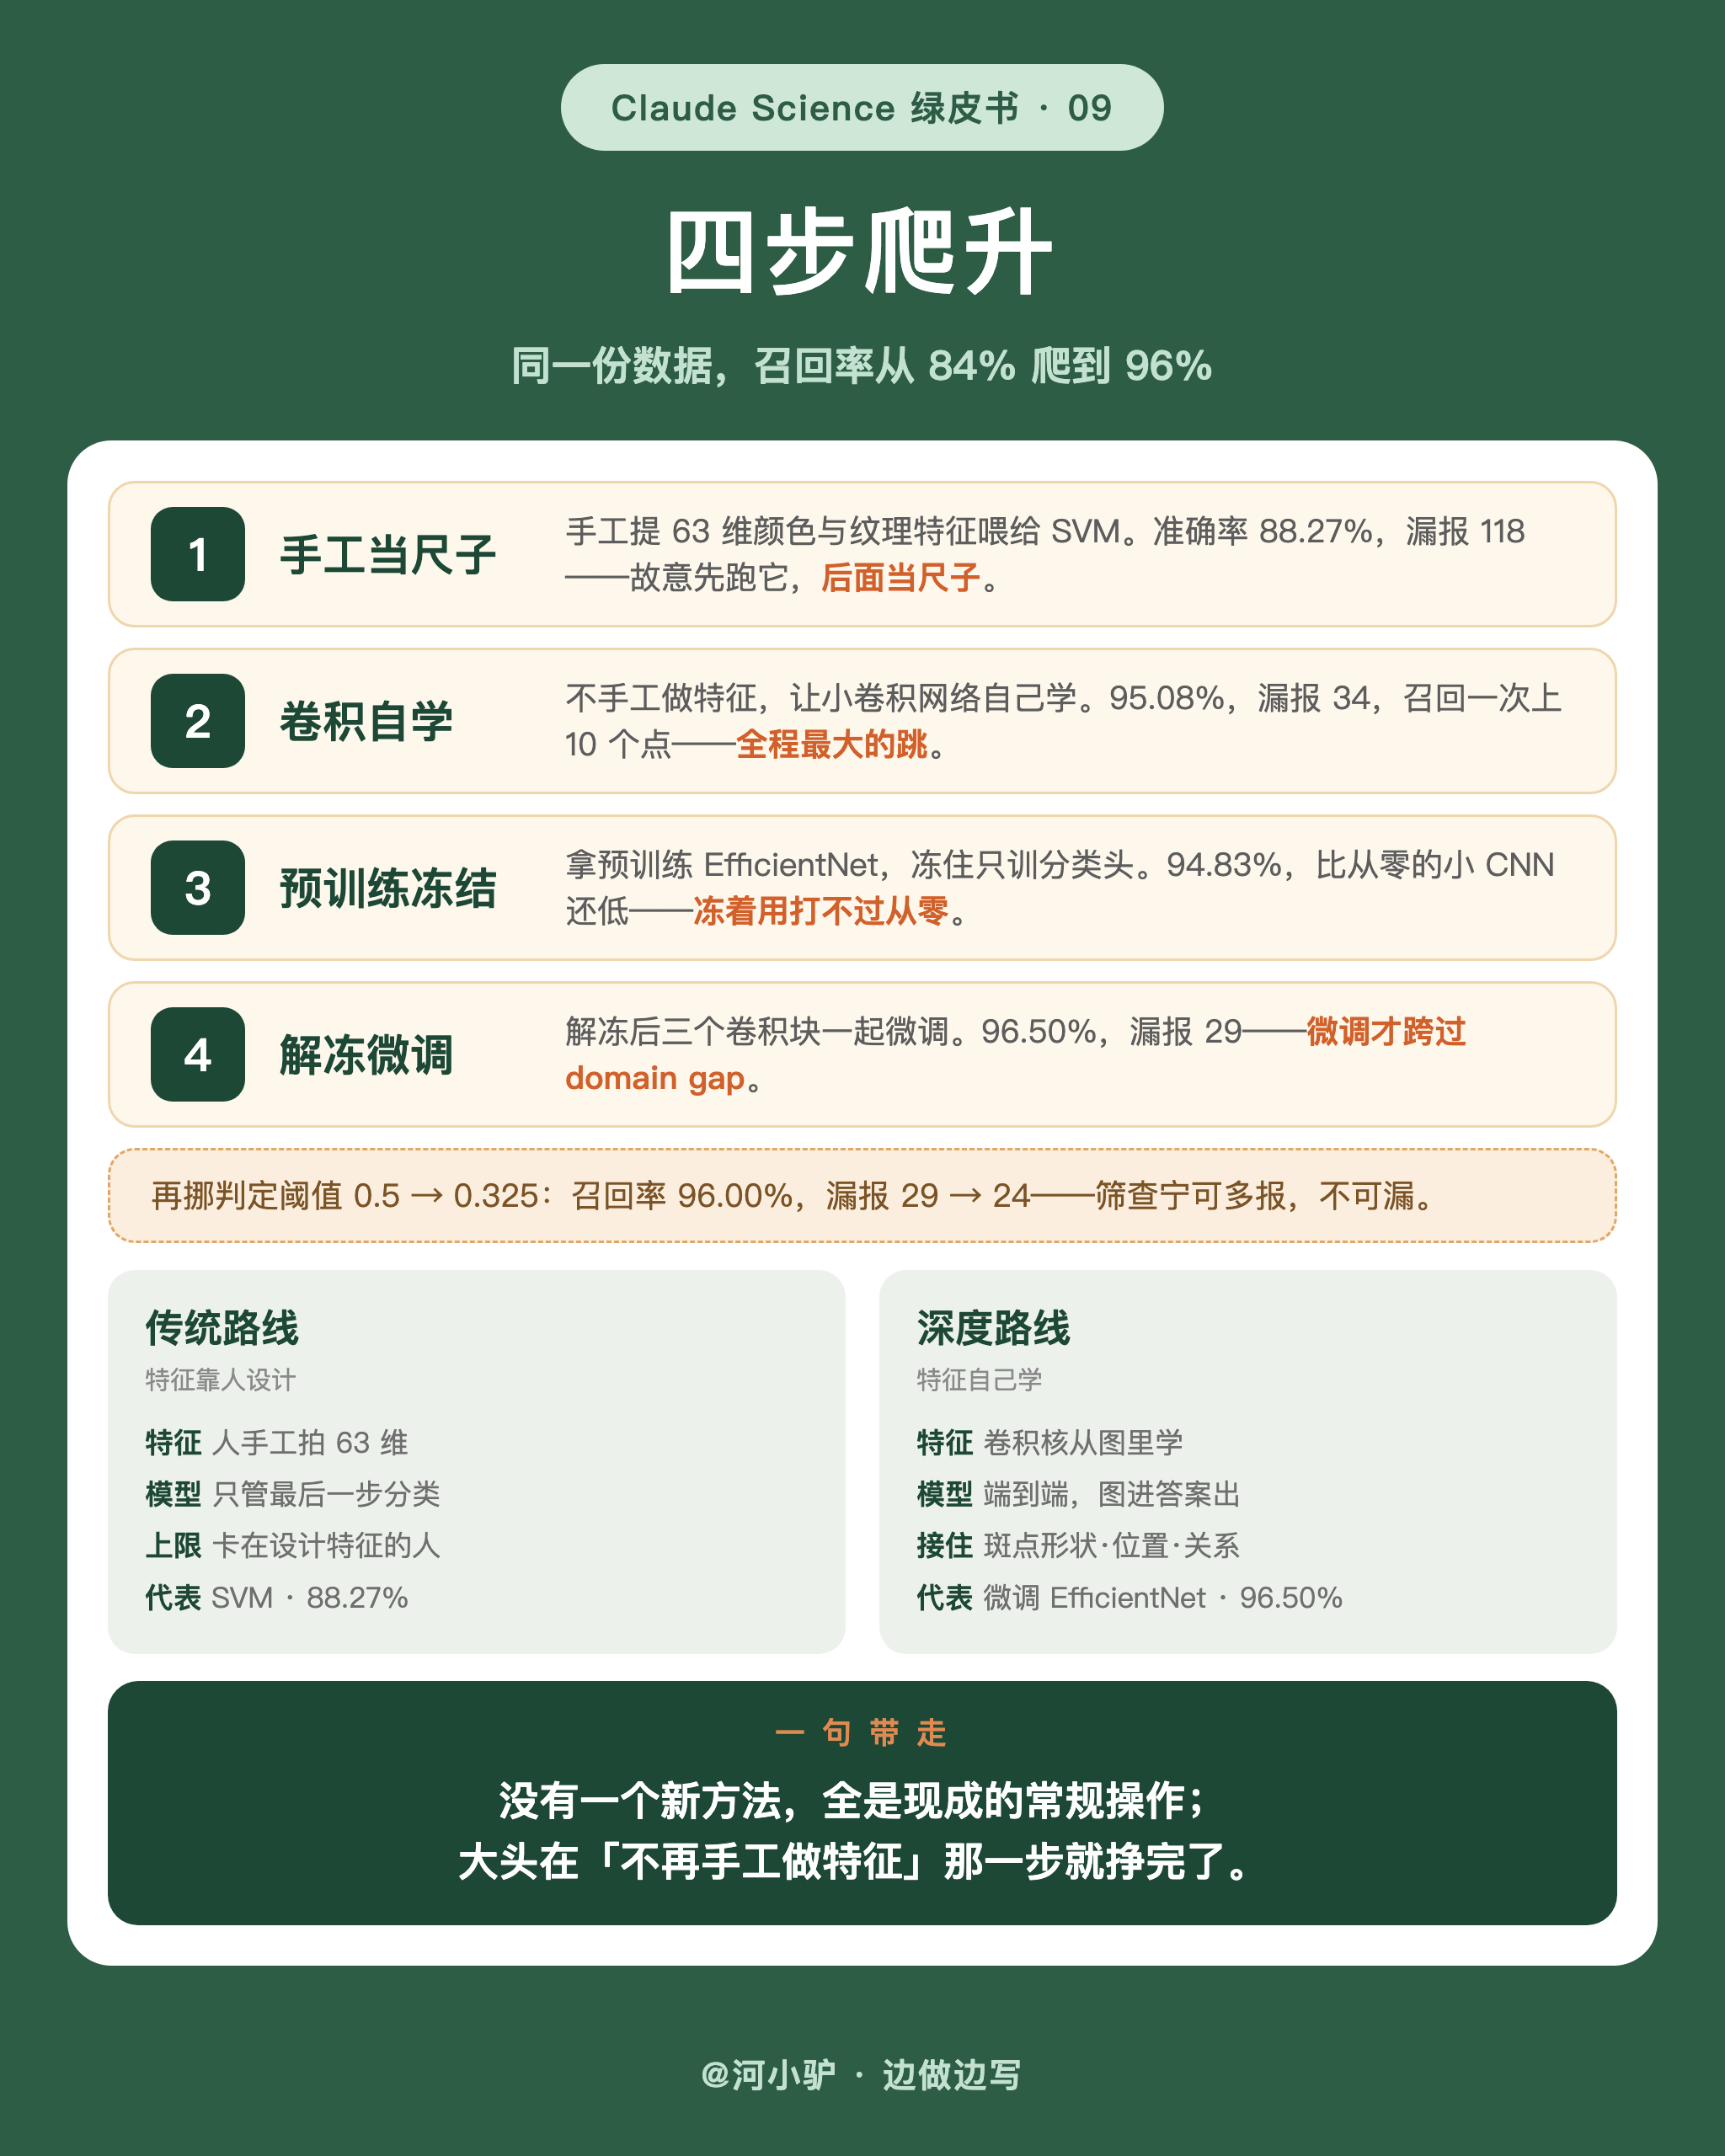 四步爬升:召回率 84% → 96%,没有新方法
下一篇
这一篇只讲实验怎么一步步优化。跑完之后,手上那四组数、九张图、一份锁死的划分文件,该怎么变成一篇论文,单独写一篇:下一篇「跑完实验之后:怎么把它写成一篇论文」。一篇标准论文分几块、每一块该交什么、这四步各自填进了哪一块,那一篇里一格一格拆。
配图都在 claude-science-green-book 仓库 articles/assets/day09/,数据与代码在私有素材库 claude-science-materials 的 day09/,本篇背后的完整论文原版(番外)在同仓库 extras/day09-malaria-paper-original.md。
论文原版也可以直接在线读:基于特征工程与深度学习的疟疾红细胞图像分类方法比较研究