10 · 好论文,改出来:一篇论文的六轮迭代
Claude Science 绿皮书 · 第 10 篇 · 2026-08-03
 Claude Science 绿皮书 10 · 写成一篇论文
上一篇把四步走完了:手工特征加 SVM,准确率 88.27%;从零搭的小 CNN,95.08%;预训练模型冻结着用,94.83%;解冻微调,96.50%。再把判定阈值挪一挪,召回率做到 96.00%。数都在那儿了。 这一篇讲下一步:这批代码、图和指标,怎么组织成一篇论文。
动手之前我以为写论文是一次性的事——实验做完,坐下来一口气写完就交。真做下来是六个版本,中间还回退过两次。而逼我大动的,多数时候不是文笔,是隔了几节就对不上的数。
先说结论
1. 论文的骨架是固定的。 标题、摘要、引言、材料与方法、结果与讨论、结论、参考文献。每一部分交什么,学界有约定,自己拆出来的分法一般站不住。
2. 写的顺序和读的顺序相反。 从结果与讨论起笔,材料与方法照着它反推,结论跟着收,引言往后放,摘要和标题留到最后。
3. 能不能填满,在做实验的时候就定了。 动笔卡壳,通常不是不会写,是当初没留下够用的记录。
4. 一轮只修一类问题。 这一轮改数据,下一轮才改排版。混着改,改完你也说不清是哪一处起了作用。
5. 写完了不是凭感觉,是有标准的。 完成度、深度、可复现,三维都到位才算交得出去。
上半部分:一篇论文该长成什么样
一、实验做完,手上到底有什么
实验跑完,我手里留下的是四样能数清的东西:
- 四组指标:四种配置在同一份测试集上的准确率、召回率、漏报数、误报数,外加调完阈值的那一组。
- 八张图:细胞样本、宽度分布、三张混淆矩阵、一条 CNN 训练曲线、两张方法对比图。
- 一份锁死的划分:记录训练集和测试集怎么分的 json 文件,以及由它算出的一串指纹码(内容改动一个字符,这串码就变,用来证明前后几版量的是同一批题)。
- 一份逐版记录:每一版改了哪里,改前改后的数各是多少。
前三样是程序自动留下的,第四样是我开始写论文时才逼着自己记的。回头看,没有第四样,前面三样再齐整,写到后半段也会乱。
二、和实验报告差在哪:七个部分,各交什么
上一节那份操作日志,其实已经是一篇完整的实验报告了:按时间顺序记着我先做了什么、后做了什么、数是多少。但它不是论文。
差别不在长短,在写给谁看。实验报告的读者是知道来龙去脉的自己人,关心的是「做了没有」;论文的读者是不认识你的同行,他要自己判断三件事:这件事值不值得做、你做得对不对、换他能不能重做一遍。所以论文不按时间排,按问题排——把同一批材料拆散,重新装进七个固定的部分里。
七个部分各写什么,实验报告里有没有现成的,一张表对照完:
| 部分 | 英文 | 这一部分写什么 | 实验报告里有没有 |
|---|---|---|---|
| 标题 | Title | 一句话说清在什么数据上、用什么方法、做到什么水平 | 缺。报告只有个文件名,论文标题要等全文定下来自己总结 |
| 摘要 | Abstract | 问题、方法、结果、结论各一两句,是全文的压缩版,要能单独读懂 | 缺。报告给自己人看,不需要摘要这个东西 |
| 引言 | Introduction | 这件事为什么值得做,前人做到哪一步,还缺什么,所以我做了什么 | 缺。实验里不会长出引言,得去读文献才写得出来 |
| 材料与方法 | Materials and Methods | 数据从哪来、多大规模、怎么划分、每一步的参数怎么配,标准是别人照着能重跑 | 有,但要整理。实验做完就都知道,只是散在日志里,要收拢成条 |
| 结果与讨论 | Results and Discussion | 用图表给出数,并解释反常的地方——不只报数,要说为什么是这个数 | 有,但没转化。数是现成的,但得按这一篇要讲的重点重新排过 |
| 结论 | Conclusion | 回答引言提出的那个问题,并说清什么条件下不适用 | 有,但没转化。报告结尾那两句还是记录,要换成站得住的判断 |
| 参考文献 | References | 正文引到的每一条都列出来,逐条可查,格式统一 | 缺。报告里根本不引文献,要从头查、从头建 |
三档分得很清楚。材料与方法是唯一一个「有,但要整理」的:划分 json、参数配置实验时就记下了,把它们从日志里挑出来收成条就成。上一篇那份锁死划分的指纹码,用处就在这里——有它,材料与方法才写得到别人照着能重跑的程度。
结果与讨论、结论这两格是「有,但没转化」。数都在,报告里也写了几句小结,但那是按时间顺序记的。搬进论文得换一个目标重排:哪几个数支撑你这一篇的重点,就把哪几个抬到前面,其余的往后放。同一批数据,换个目标就是另一张表。
标题、摘要、引言、参考文献这四格是真的缺,实验里根本不会产生,得一个字一个字手搓。引言要读完文献才写得出,参考文献要逐条去查,摘要和标题要把整篇压成几句话。写论文比写报告多出来的工作量,大半就在这四格上。
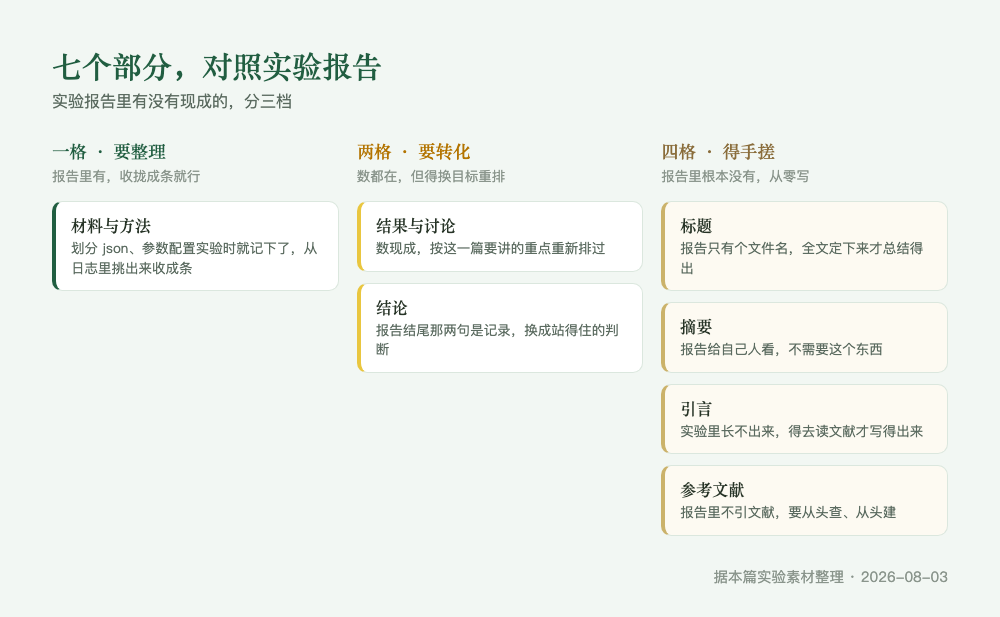 七个部分对照实验报告:一格要整理、两格要转化、四格得手搓
三、真实的写作顺序:从结果倒着往前写
上一节把七个部分分成了三档:要整理的、要转化的、得从头手搓的。写作顺序就是这个分法的直接结果——先写手里有底子的,再写要从头想的。读论文是从摘要往下读,写的时候几乎相反。照着成品顺序从标题写起,第一步就会卡住:还没定下自己做出了什么,标题就无从下笔。我这一篇的实际动笔顺序是这样:
| 顺序 | 写哪一部分 | 为什么放在这个位置 |
|---|---|---|
| 第 1 步 | 结果与讨论 | 图和数是现成的,不用编。先把它定下来,全文才有个准头 |
| 第 2 步 | 材料与方法 | 照着结果反推:结果里出现的每一个数,方法里都要有对应的配置交代 |
| 第 3 步 | 结论 | 接着材料与方法往下收,把量出来的数变成一句能站住的判断 |
| 第 4 步 | 引言 | 本质是相关工作。知道自己做出了什么,才知道该跟谁比 |
| 第 5 步 | 摘要与标题 | 全文定了,摘要才是压缩,不是预告 |
| 最后 | 参考文献 | 正文引到哪补到哪,逐条核实后统一整理格式 |
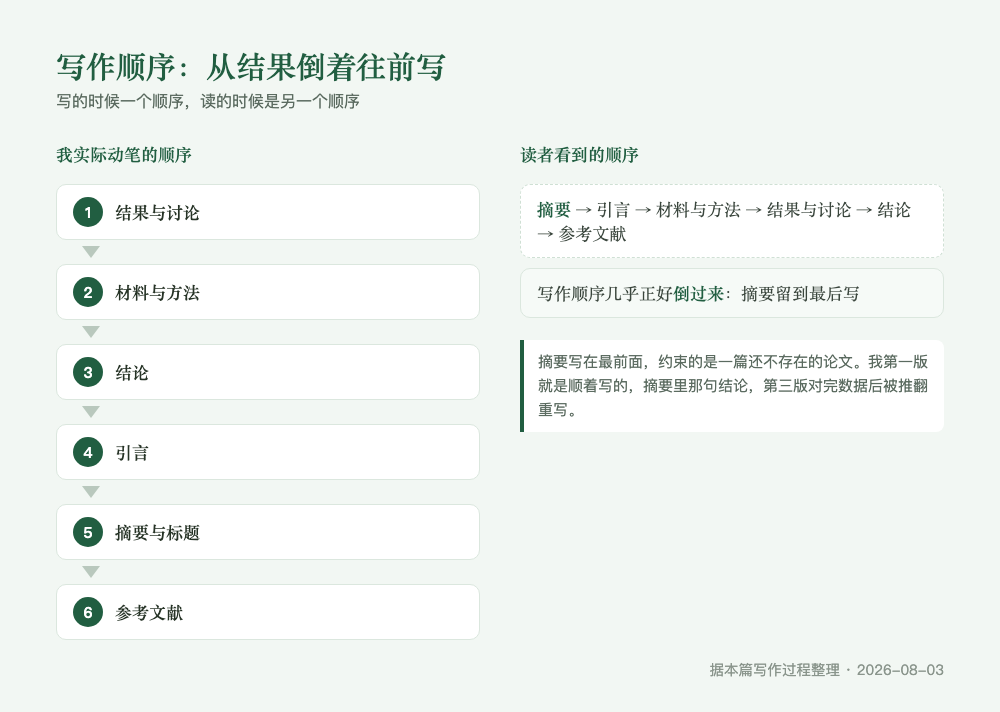 写作顺序:从结果与讨论起笔,摘要留到最后
倒着写的道理很直接:摘要如果写在最前面,它约束的是一篇还不存在的论文。 我第一版就是顺着写的,摘要里那句结论,在第三版对完数据之后被推翻重写。
下半部分:这篇论文改了六轮
四、六轮改下来,每一轮改了什么
六个版本都留在私库里。往下看之前,先把衡量的三把尺子交代清楚,后面每一轮都用它们说话:
- 完成度:该有的有没有。七个部分齐不齐、每格该交的交了没、格式合不合学术规范。
- 深度:想透了没。反常的地方有没有解释,适用边界有没有划出来,讨论是停在报数还是往下走了一层。
- 可复现:别人能不能照着重做。划分怎么定的、参数怎么配的、公式列没列、文献查不查得到。
篇幅不在这三把尺子里。后面会看到,改得最值的两轮,稿子反而是变短的。
第一步:把流水账装进骨架
第一版只能算个雏形:七个部分的壳搭起来了,里面大半是空的,一张图都没有。
实验刚做完时,我手上只有一份按时间顺序记的操作日志。这一轮我没有新写内容,只做了一件事:把流水账打散,按七个部分重新装。属于方法的归方法,散在叙述里的数值全部提到结果那一部分。
装完,空缺立刻露出来:结果部分只有文字没有图,讨论和结论各只有两句话。第一轮的价值不在写了多少,而在看清还欠多少。
第二步:图补上了,隐患也埋下了
第二版补上了八张图,完成度往上走了一格。
有了混淆矩阵和训练曲线,结果部分才立得住。但也是这一轮出的错:正文里把漏报数写成了 16,混淆矩阵图上是 29。同时,正文引的八条文献,一条都没核对,作者和年份都是凭印象写的。
当时精力全在图和排版上,没有回头拿图去对正文。这是论文最容易飘的阶段——看起来有图有据,底下的数其实还没对上。
第三步:把对不上的数改回来
第三版是六轮里改动最重的一轮,也是可复现第一次真正立住的一轮。
漏报数从 16 更正为 29,混淆矩阵同步改回真实数据。这个数一动,影响的地方不止一处:摘要里的结论句、结果部分的描述、讨论里关于漏报代价的判断,全部跟着重写。
同一轮,我把八条文献送进 Crossref(一个公开的文献登记库,凭编号可以查到文献是否真实存在)逐条核实。
论文很少倒在文笔上,多数倒在数据自相矛盾上。这一轮如果没把 16 揪出来,后面三轮排得再干净也是白费。
第四步:把方法补到能照着复现
第四版篇幅不增反减,可复现却在这一轮一次到顶。
我补了四个公式(手工特征怎么算、损失怎么定义),并补上两条源头文献:支持向量机的原始提法(Cortes 与 Vapnik,1995)、ImageNet(Deng 等,2009)。
补了内容篇幅反而缩了,因为公式一列出来,原先那些「先对图像做了一些灰度处理,接着做了对比度拉伸」的含糊长句就显得多余,被我整段删掉。能用公式和参数说清的,不必用句子绕。
第五步:排版排不进去的,往往是没想清的
第五版动的是格式,却在格式上撞出了一个逻辑问题。
这一轮本意只是收拾格式:表格换成学术期刊常用的三线表,图题置于图下、表题置于表上,图片按三档宽度统一。
排到「判定阈值从 0.5 降到 0.325」那一段时卡住了。几组不同阈值下的准确率和召回率混在一段里交叉对照,怎么排都读不顺。这时才意识到,不是格式难调,是这一段的对比逻辑本来就没理顺。于是停下排版,把这些数抽出来单独做成一张对比表。同一轮,我在讨论部分补了一段:换一家医院、换一台显微镜,这个模型的表现很可能下降。
排版别扭的地方,通常就是逻辑没理顺的地方。
第六步:往回删
第六版只做减法,完成度在这一轮补满,导出 PDF 定稿。
我删掉一条引用不够准确的文献,全文文献从八条收到七条。这一轮没有往里加任何新内容。收尾那一轮如果还在加东西,说明前几轮没改到位。
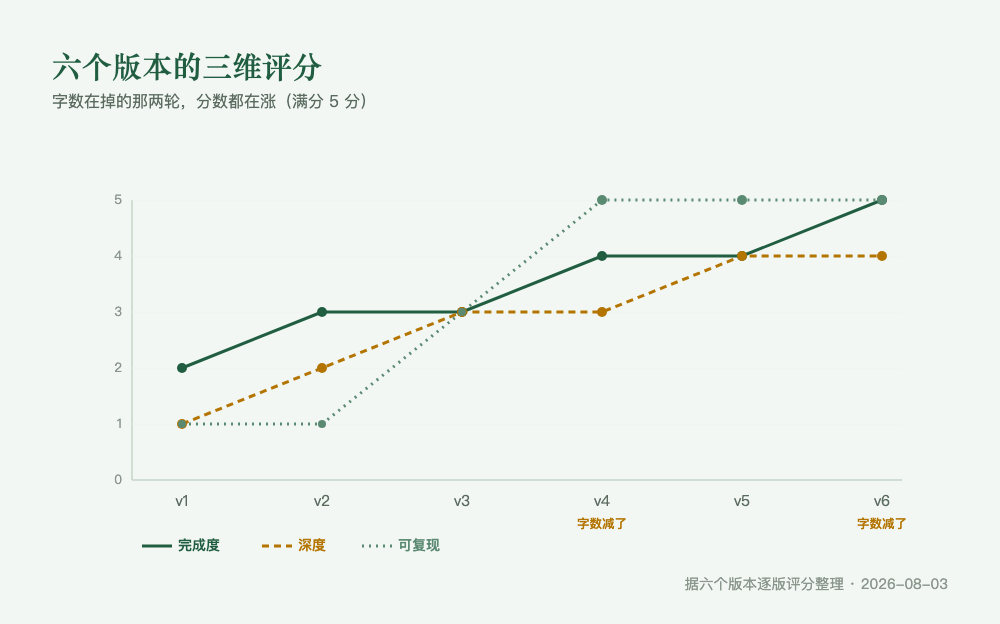 六个版本的三维评分:完成度一格格爬,可复现跳着涨
六个版本放在一起看
把前面那三把尺子逐版打一次分,满分 5 分:
| 版本 | 这一轮只改 | 完成度 | 深度 | 可复现 |
|---|---|---|---|---|
| v1 | 按七部分重装 | 2 | 1 | 1 |
| v2 | 补齐八张图 | 3 | 2 | 1 |
| v3 | 更正数据、核实文献 | 3 | 3 | 3 |
| v4 | 补公式与源头文献 | 4 | 3 | 5 |
| v5 | 调学术格式 | 4 | 4 | 5 |
| v6 | 精简删减 | 5 | 4 | 5 |
三条线的涨法不一样。可复现是跳着涨的:第四版把公式和源头文献补上,这一维一次到顶,而那一轮稿子是变短的。完成度是慢慢爬的,最后一轮才补满。
深度停在 4 分没再动,这一点值得单说。这一篇做的是常规优化,没有提出新方法,深度到这里就是它的上限,硬往上写反而不实。把一件常规的事做完整、做到别人能复现,本身就是可交付的工作。
五、这六轮守的三条规矩
改六轮不难,难的是每一轮都确实比上一版好,而不是原地打转。我守住的是这三条:
一轮只修一类问题。 第三版只动数据,第四版只动方法,第五版只动格式。混着改的后果是:改完发现变好了,却说不清是哪一处起了作用,下一篇没法复用。
每一版都另存一份。 不在原文件上覆盖。六份稿子都在,我才能在第五版发现问题时,反查出那个 16 是第二版混进来的,也随时能退回去重来。
每一轮都要有人核。 改完对着上一轮列出的问题逐条验收,改了的说明改法,没改的说明理由。没有人盯,改着改着就会偏成另一份稿子,而不是改好的这一份。
这三条不是写作技巧,是从实验里搬来的。上一篇的四步优化——经典方法做基线、自搭小 CNN、预训练网络、解冻微调——每一步只动一个配置,动完在同一批测试集上量一次。实验里叫控制变量,写作里就是一轮只修一类。两件事能成立,靠的是同一个前提:每一步改动都能单独拎出来,看清它究竟改好了什么。
反面的例子就在手边。如果当初没用指纹码把那一万多张测试图的划分锁死,到了第三版我连改数据的底气都没有——重跑一次程序,数就全变了,分不清是原先写错还是这次结果本就不同。材料与方法、结果与讨论这两个最硬的部分,会在同一时刻一起失效。
六、写到什么程度算完
第六版定稿那天,我没有再想加什么,这才是可以停的信号。把这个感觉翻译成能对照的标准,就是下面这张表:
| 维度 | 及格(3 分) | 可交(5 分) |
|---|---|---|
| 完成度 | 七个部分都在,每格该交的都交了,同一个数字全文对得上 | 再加格式合规范:三线表、图题在下表题在上、单位与小数位统一 |
| 深度 | 结果里反常的地方给了解释,不是只报数 | 再加主动划出没验证的范围,说清换个场景可能失效在哪 |
| 可复现 | 数据来源、划分方式、关键参数都写了 | 再加关键公式列出,每条文献可查证,别人能独立重跑 |
三维都到 5 分,就是我认为的写完了。第六版是 5 / 4 / 5,深度差一分,那一分我不打算硬凑。
拿去给 AI 打分的提示词
把自己的稿子和下面这段一起发给 AI,它会按这三维给你打分并指出扣分位置:
你是一位审稿人。请按下面三个维度给我这篇稿子打分,每维 0-5 分,并指出扣分的具体位置。

【完成度】
- 七个部分是否齐全:标题、摘要、引言、材料与方法、结果与讨论、结论、参考文献
- 每部分是否交了它该交的:摘要是否含问题/方法/结果/结论四要素;结论是否回答了引言提出的问题
- 全文数据是否一致:同一个数字在摘要、正文、图表中是否对得上,逐个核对并列出不一致的地方
- 格式是否规范:表格形式、图题表题位置、单位与小数位是否统一

【深度】
- 结果里反常或低于预期的地方,有没有给出解释,还是只报了数
- 有没有主动划出适用边界,说清在什么条件下可能失效
- 讨论是停在复述结果,还是往前推进了一层

【可复现】
- 数据来源、规模、划分方式是否写清,别人能否拿到同一批数据
- 关键参数是否完整:模型配置、训练轮数、随机种子
- 关键公式是否列出,还是只有文字描述
- 参考文献是否逐条可查,与正文引用是否一一对应

输出要求:
1. 三维得分各一行,写明扣分理由
2. 扣分点清单,按严重程度排序,每条注明在原文哪一节
3. 只指出问题,不要替我改写
4. 最后告诉我:下一轮应该只改哪一类问题

注意:一轮只修一类。不要一次性把所有改法都给我。
每改完一轮重新跑一次,三维分数的变化比篇幅诚实得多。
复盘
六轮里真正拉开差距的是第三版和第六版——一个是把埋进去的错挖出来,一个是做减法收尾。中间几轮的填充之所以有效,是因为第一轮先把骨架摆在了台面上。如果重来一次,我会把核实文献提到第二版,它和补图排版并不冲突,一直拖到第三版,只是把工作量堆在了一起。
说到底
论文不是最后一口气写出来的,是做实验时一点点存下证据,再在桌面上反复拆解、一轮轮改出来的。
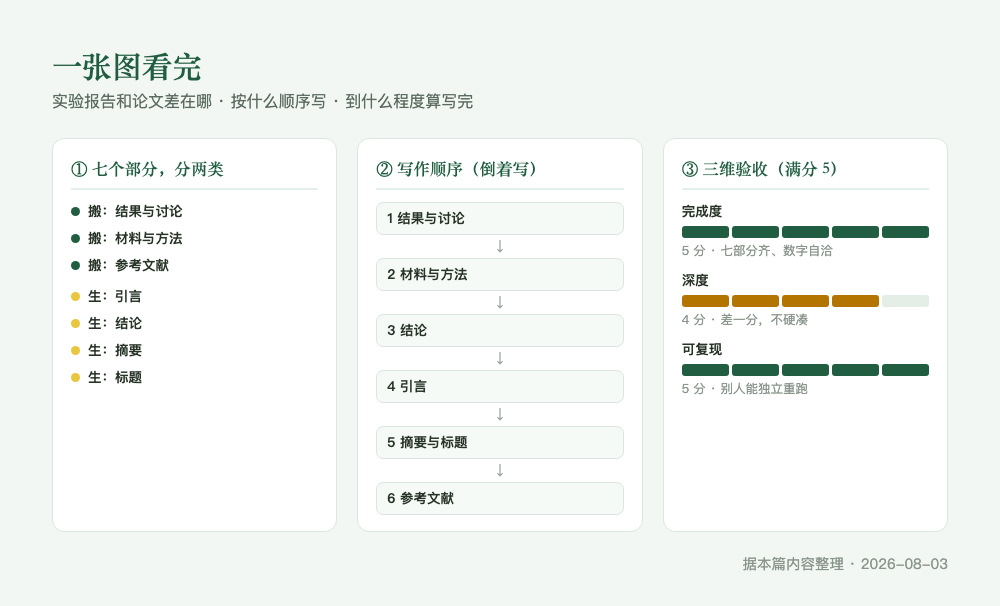 一张图看完:实验报告和论文差在哪、按什么顺序写、到什么程度算写完
下一篇
下一篇换个打法:不聊怎么写论文了,直接拿 Claude Science 去打一个比赛——世界人工智能开源大赛(GOAI)的「AI for Research」赛道,主题正好就是 AI 和科学的交叉。这一篇讲的六轮改稿、三维验收,到那边全是真刀真枪要用上的东西。看看这套打法上了赛场,能顶到哪一步。