11 · 30 分钟速通比赛:一个工具包,把初赛方案写到能交
Claude Science 绿皮书第 11 期 · 2026-08-05
 Claude Science 绿皮书 11 · 30 分钟速通比赛
上一篇讲的是把一堆实验数据改成一篇论文,改了六轮。这一篇换个场景:一个比赛给了模板和截止时间,怎么在半小时里把方案填到能交。
这个比赛是这么回事。GOAI 世界人工智能开源大赛 2026,主办方是杭州市开源人工智能基金会,7 月 16 日开报名,8 月 16 日截止交初赛作品,9 月 22 日在杭州办总决赛,四条赛道分 500 万现金奖池。我报赛道三「前沿探索 AI for Research」,这条赛道的学习营由 Datawhale 协办,官方 baseline 任务就是从那边放出来的。
这一篇带着把这个 baseline 跑完。任务本身很清楚:交一份初赛方案,用官方 Word 模板,五个一级标题、十三个小节,标题一个字不能改,正文 3000–5000 字。
模板下载下来一看,标题都在,内容一个字没有。
我第一反应是把模板扔给 AI,让它照着写。它写出来了,四千字,格式全对。我读完一遍就知道这份不能交。差的不是写作能力:模板里真正缺的三样东西——我打算做哪个材料领域、手上有什么资源、能投多少时间——它一件也不知道。
先说结论
- 方向三要的是一个文献调研智能体:检索、抽取、找缺口、出证据链报告,每一步都要能回溯到原文
- 四条红线里最狠的是零虚假引用,编造一条文献就直接出局,这比分数低严重得多
- 顺序得反过来:先把只有我能回答的那几个问题答完,再让 AI 动笔写全文
- 我把这件事拆成三段:六轮提问把内容问出来,脚本填进官方模板,AI 按官方维度打分再照着改
- 熟了之后跑一轮 30 分钟,一半时间花在回答提问上;第一次上手按两小时预算
一、这个比赛要你干什么
赛道三下面分了几个方向,我跑方向三:材料科学文献驱动的科学发现智能体。智能体在这里的意思很具体:一个能自己拆活、自己搜文献、自己把结果整成报告的程序。官方还多要一层:报告里的结论要能被后续实验或计算推翻,也就是可证伪,不能是一句读起来对、但没法检验的话。
任务分两块。必做的那块是文献调研智能体,四步:
- 检索筛选:多源搜完之后去重、去噪、排序
- 知识抽取:抽出成分、结构、性能、工艺条件
- 缺口识别:从真实证据里找出还没人做的问题
- 证据链报告:出结构化报告,每句结论能指回原文
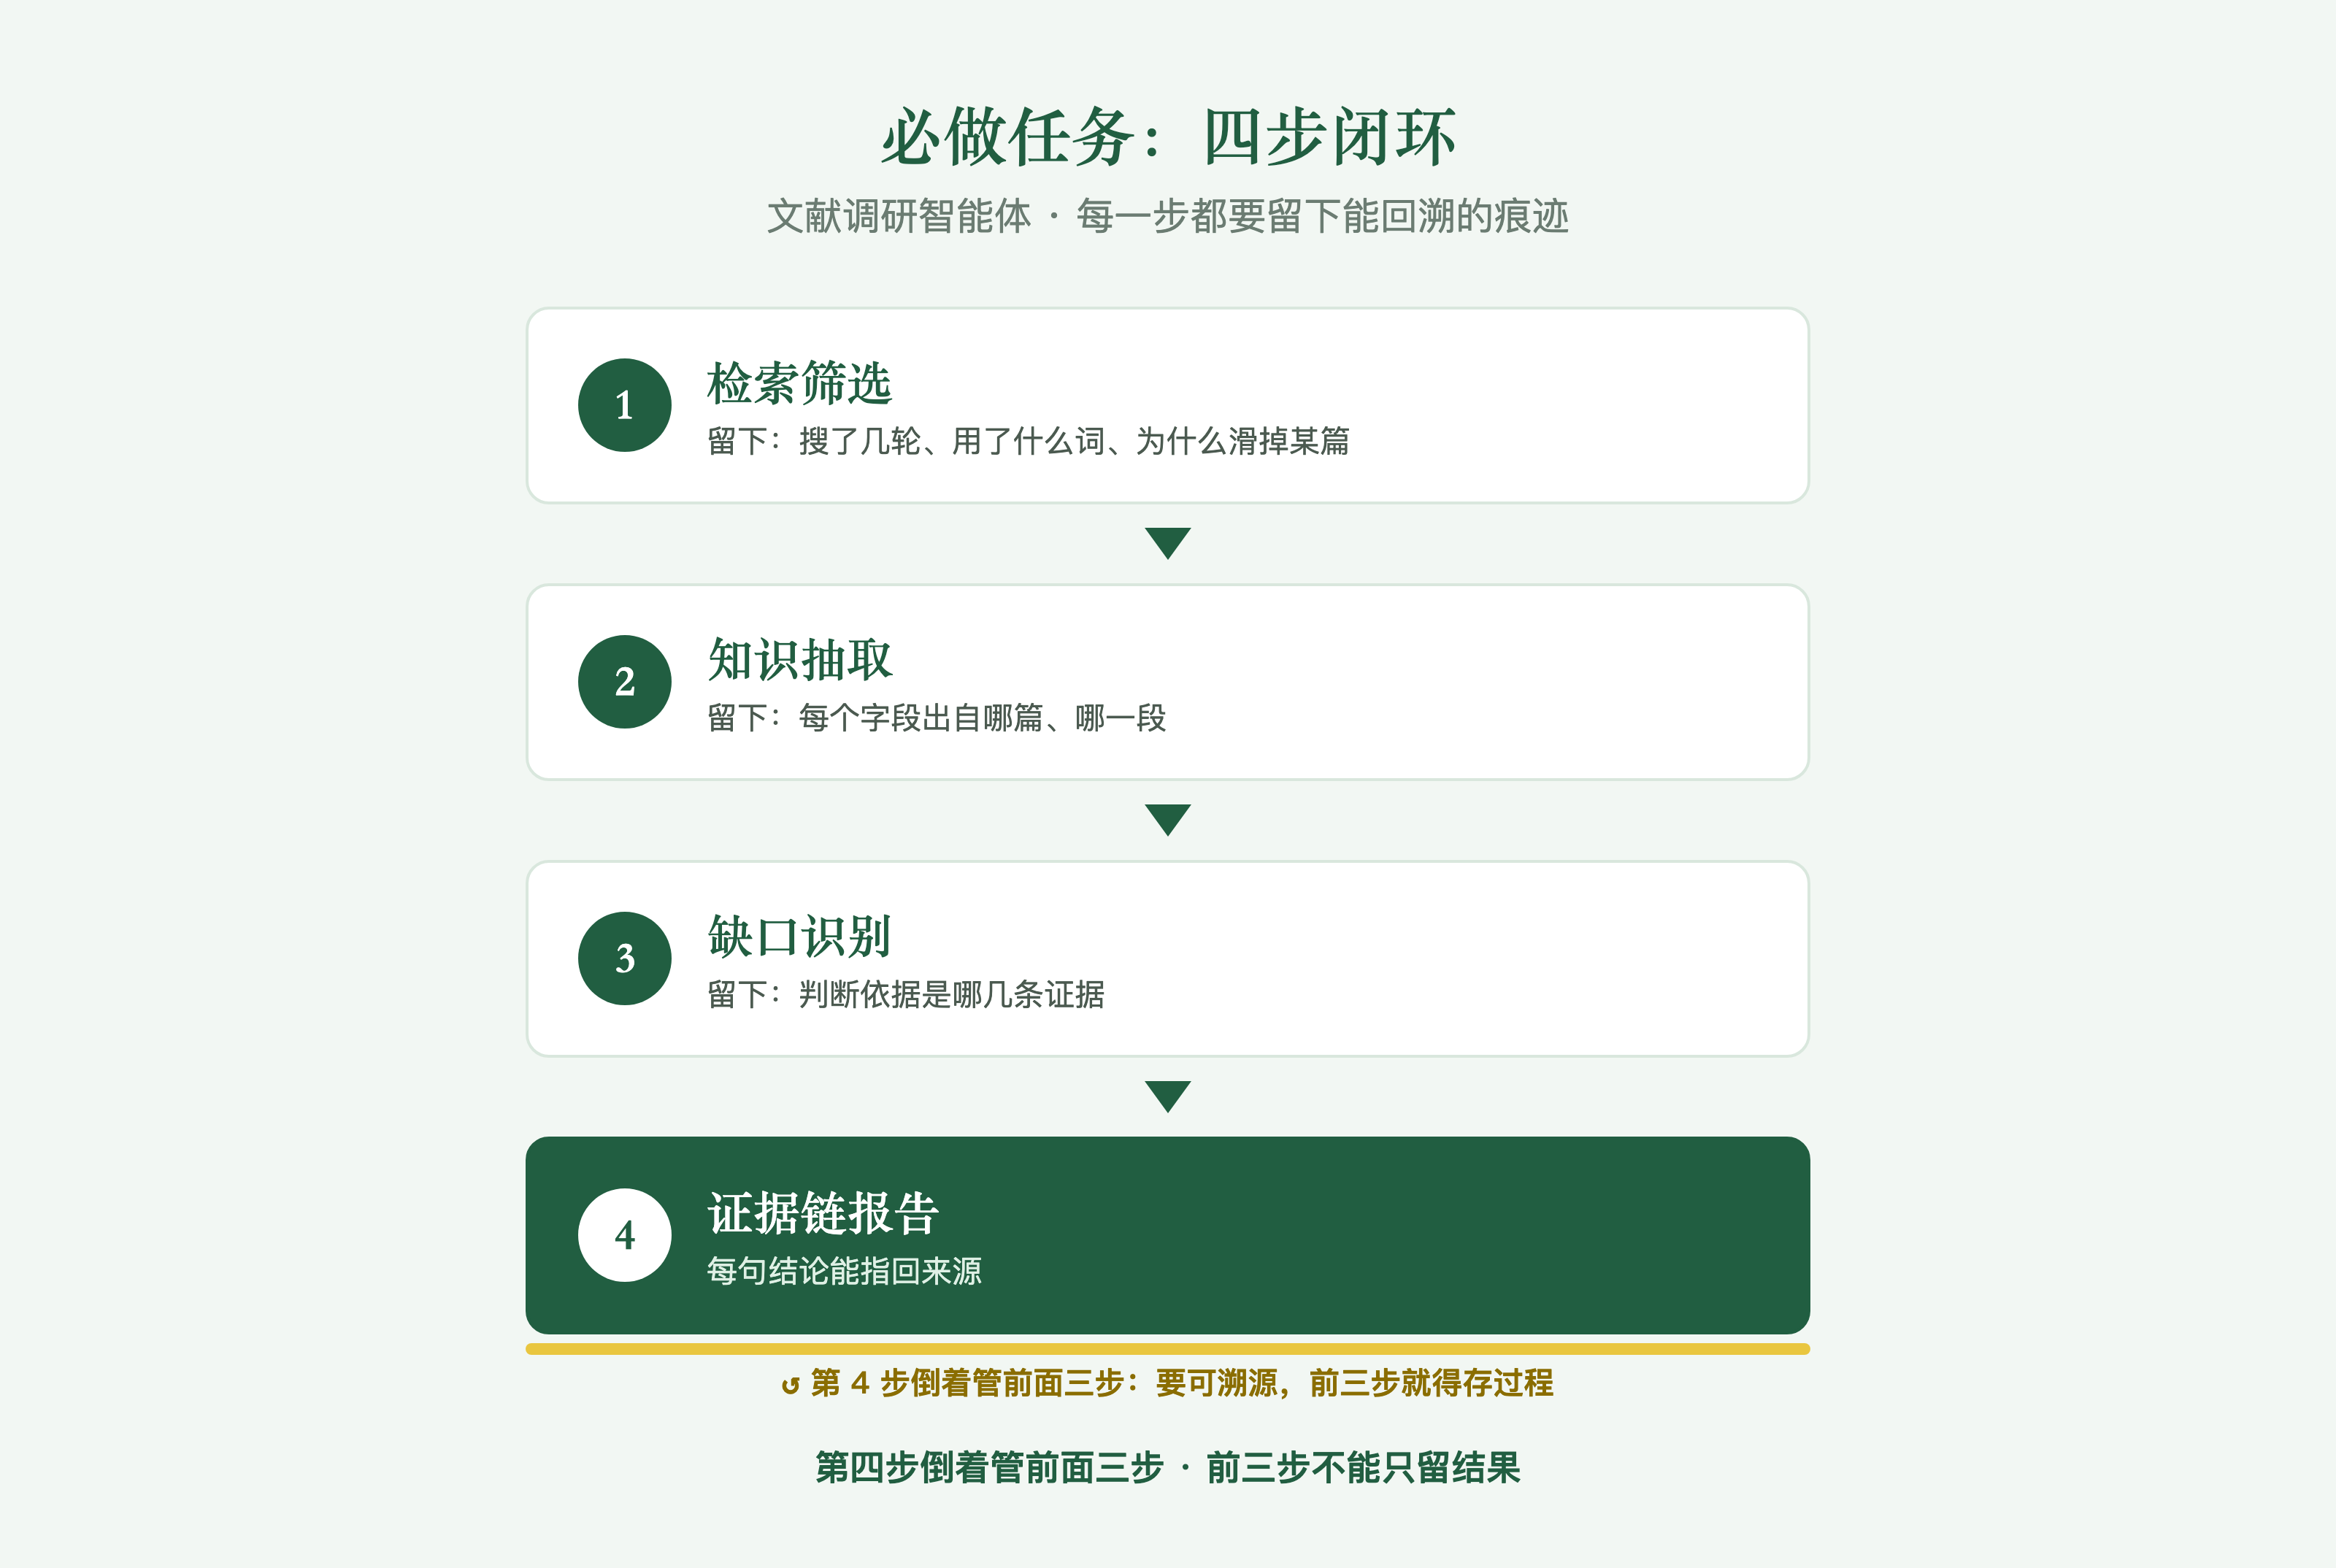 必做任务四步闭环:每一步都要留下能回溯的痕迹
四步单看都不新鲜。难的是第四步倒着管前面三步:报告里每句话都要能指回来源,那前面三步就不能只留结果,得把过程也存下来。检索了几轮、用了什么词、为什么把某篇滑掉,这些当时不记,事后补不回来。
选做的那块是三选一:从文献里挖成分结构跟性能的关系、再给出新候选;做模拟计算;给合成路线。第一条路的要求写得最硬:模型必须真参与搜索过程,不能只在最后写个总结;找出来的新候选还要跟公开材料数据库对上。初赛只要给出路线设计,不要求做完。
初赛交三件:调研报告、系统说明、路线方案。系统说明允许基于开源项目搭,但必须说清自己加了什么。路线方案就是这一篇要讲的那件,也是官方 baseline 任务指定的那件。官网最多让交三次,以截止前最后一次为准,所以早交一版占位不吃亏。
评分是四个维度:技术方案 45、科学意义 30、创新 20、开源 5。材料方向内部还细分了一层,必做和选做各占一半。流传的「60 分线」是流程完整加发现有效加引用干净:解析、抽取、假设、证据、提交这条链要走通。看完这三段我的判断是:这题拼的不是创意,是完整度。
二、四条红线,踩一条出局
官方把四条硬约束单列出来了,没有写进评分表,但位置比评分表高。
- 证据链:每条结论都要能追溯到具体的文献或数据来源
- 新知与已知分清:不把已知事实包装成自己的发现,也不把假设当结论
- 拒绝黑箱:智能体为什么这么判、为什么选这条,要能说清、能审
- 零虚假引用:一旦发现编造的文献或引用,直接出局
前三条是写法问题,写得粗糙扣分;第四条不是扣分,是取消资格。而偏偏这一条最容易被踩到。方案里写到「已有研究表明……」这种句子,如果是 AI 顺手接上去的,后面往往跟着一条看起来很真的引用。AI 那边没有造假的意思,它只是想把句子补完整。
所以我在包里写死了一条:只给结构,不给假数据。自己提不了的内容,标一个【待补充】放着。空着能补,编了没得补。
除了红线,官方解读里还提了三个常见坑:贪多嚼不烂、只堆文字不跑流程、模型不在回路。三条指的是同一个毛病——方案写得很漂亮,但没人真跑一遍。
三、模板到手,还是写不动
开头那三样东西,缺一样都写不动,为什么?
领域没定,检索策略、评价指标、验证方案就都没有落点,只能写成哪个领域都能套的一段;资源没数,工具表只能照抄官方推荐,说不清哪些我真跑得起来;时间没数,路线就分不清初赛做到哪一步、决赛再往前推什么。三样都空着,AI 只能把模板标题换个说法再说一遍。
标题是官方定的,内容只能我自己给。我一句「帮我写」什么都没提供,它只能拿行业平均值填。
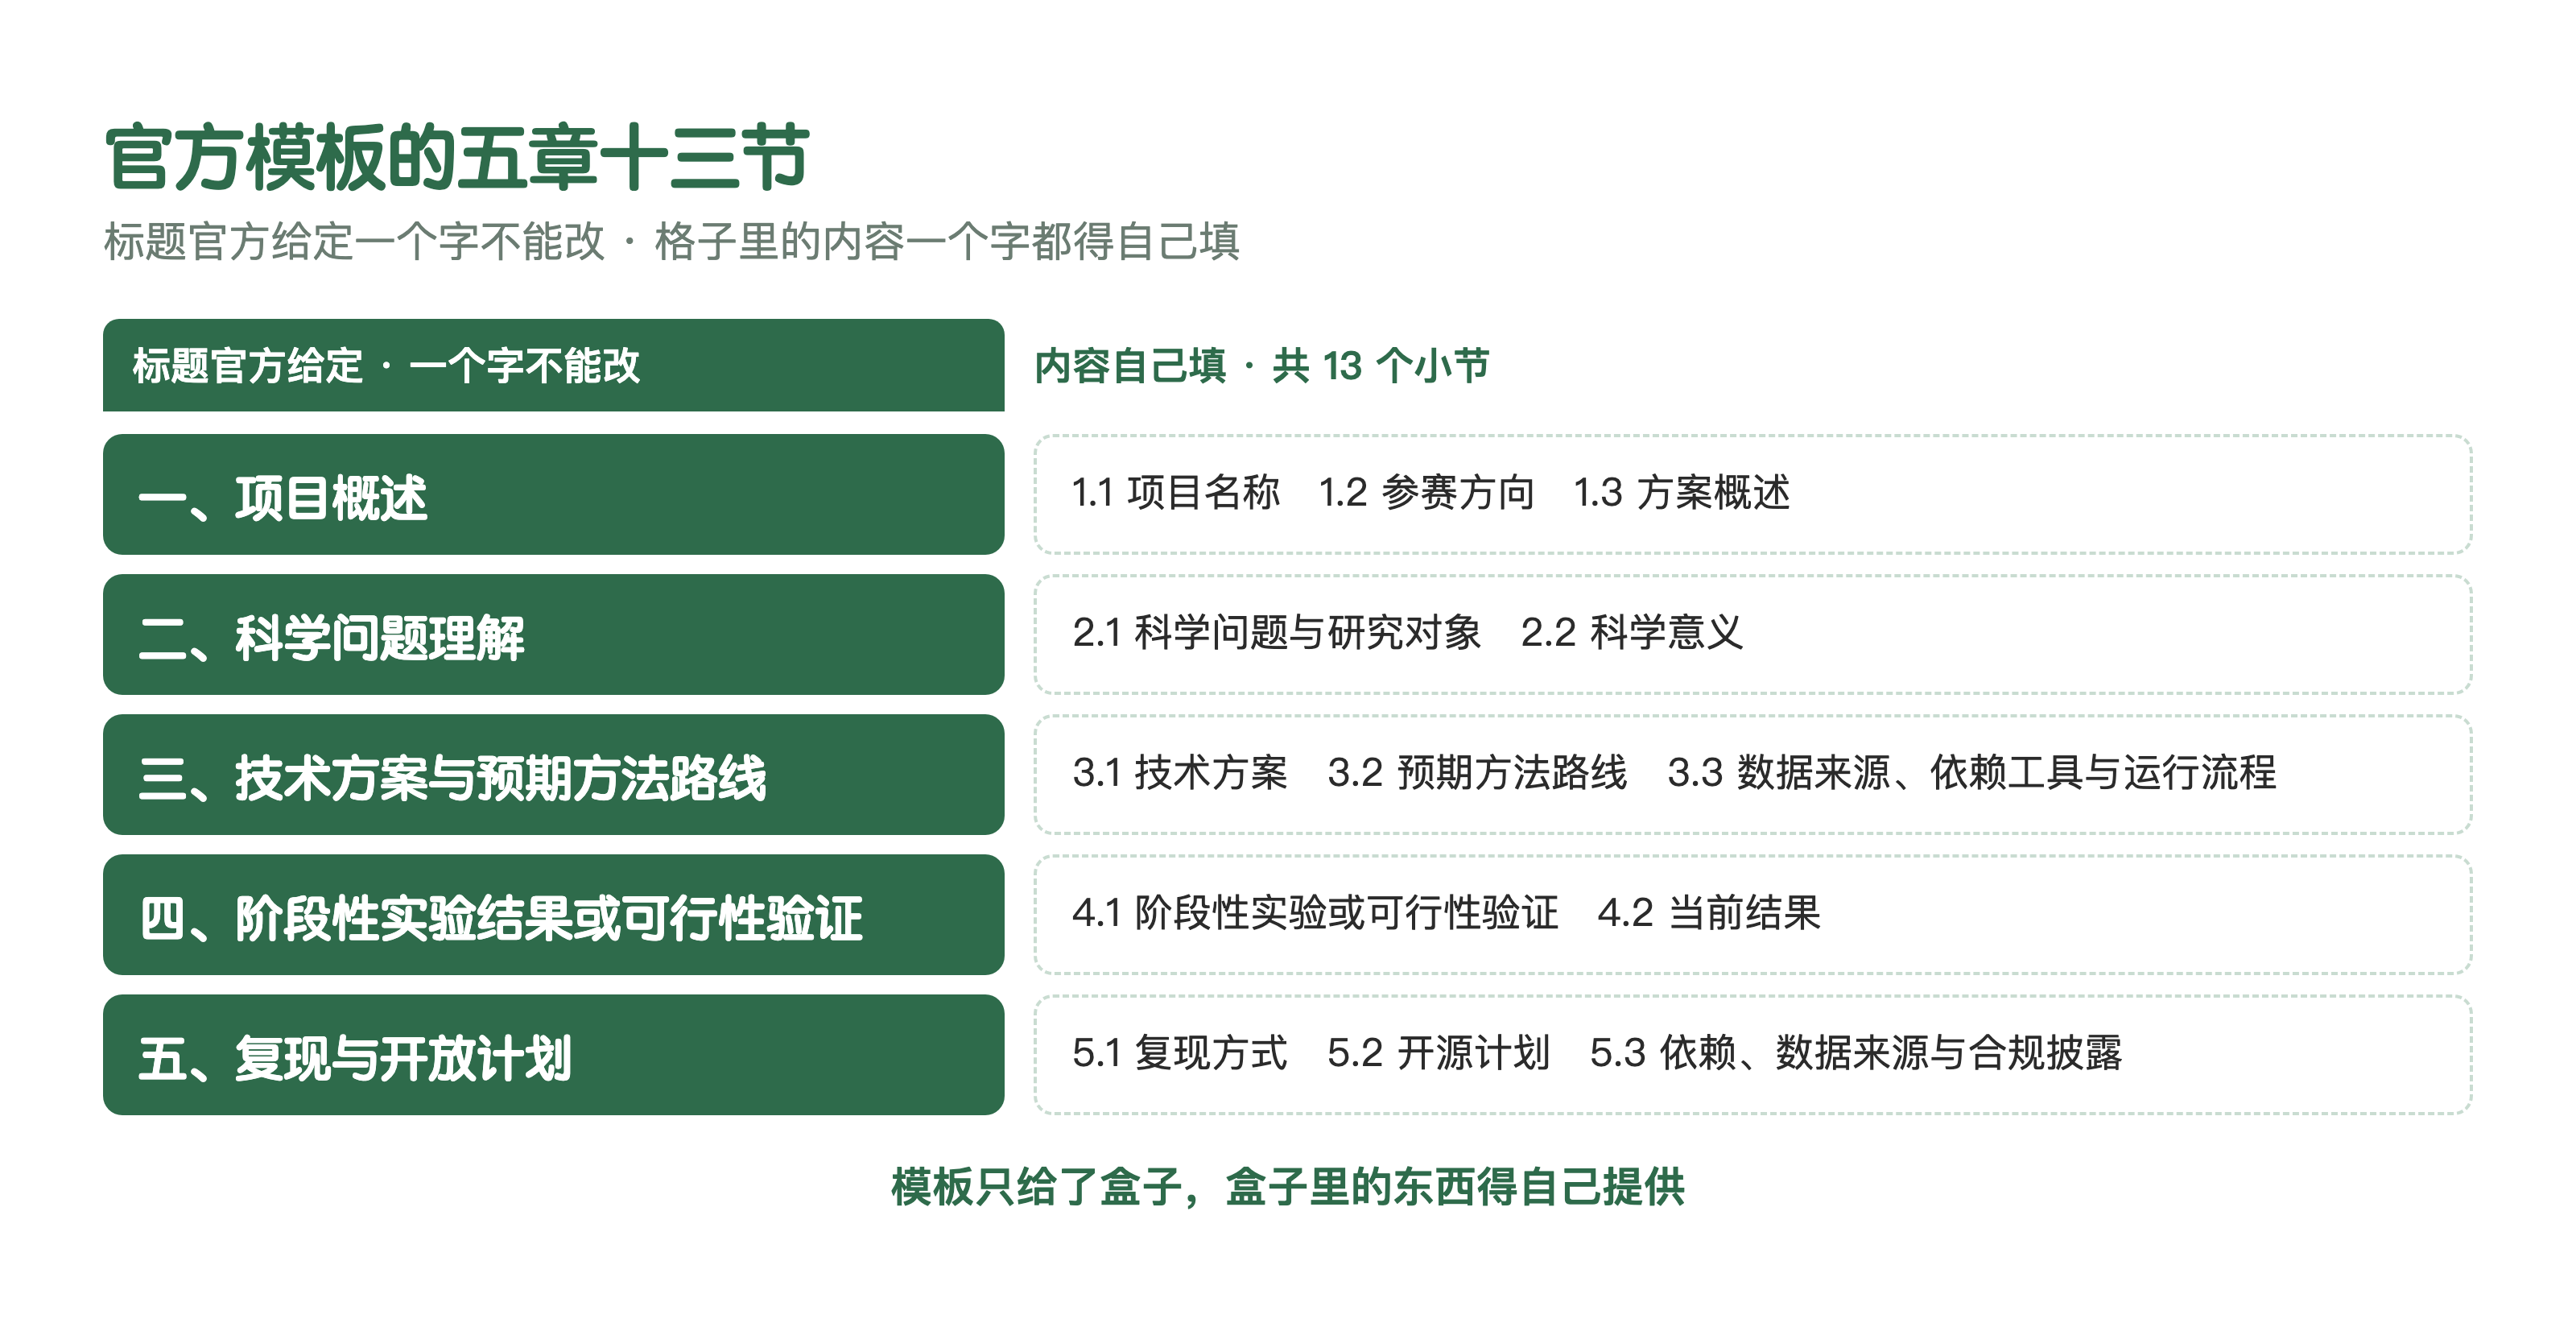 官方模板的五章十三节:标题全是给定的,格子里的内容一个字都得自己填
那顺序就得反过来:先把这些事问清楚,再动笔。这套问法是别人先做出来的,@WinnerLoveSheep 的 TRQA 十轮问答法就干这个:把「思考」和「建造」分开,问够了再开工。我把它压成六轮,因为这比赛的模板标题已经给定、任务边界也清楚,不需要十轮那么发散;再把官方模板、评分维度、红线自查一起打包,就成了这个包。
四、包里备了什么料,省掉哪些活
包只管三件套里的第三件,也就是路线方案。调研报告和系统说明那两件我没放进去。
| 东西 | 干什么用 |
|---|---|
| 背景卡 | 方向三的任务说明压成一页:必做加三选一、四条红线、三件套、评分与 60 分线 |
| 提示词 | 三部分:六轮提问的脚本、逐节填写的提示词、评分用的提示词 |
| 输出模板 | 官方 Word 模板两份,标准版和含团队介绍版,原样收录不动标题 |
| 评价指标 | 官方四个维度的权重、四条红线、给 AI 用的打分锚点 |
| 提问方案 | 六轮竞赛适配版:勘察两轮、设计两轮、验收两轮 |
| 官方原件 | 赛事手册全文和官方标准提示词也收进仓库了,想跑官方流程可以不走我这套 |
| 两个技能 | 说「开始 baseline」走六轮提问到填文档;说「评分」出一份模拟评审报告 |
| 一个脚本 | fill_template.py:把回答整成的数据文件填进官方模板;内容里有团队那几节就自动换成团队版 |
| 一套示例 | 虚构热电领域的完整演示,示例方案正文 3896 字。领域、成员、数字全是编的,只用来看结构 |
装完之后上手就两句话:
git clone https://github.com/Dalaoyuan2020/ai4r-baseline-kit.git
pip install python-docx
然后在仓库目录里打开 AI 编程助手,说「开始 baseline」。
五、六轮提问:先勘察、再设计、后验收
六轮分三段,每段两轮。
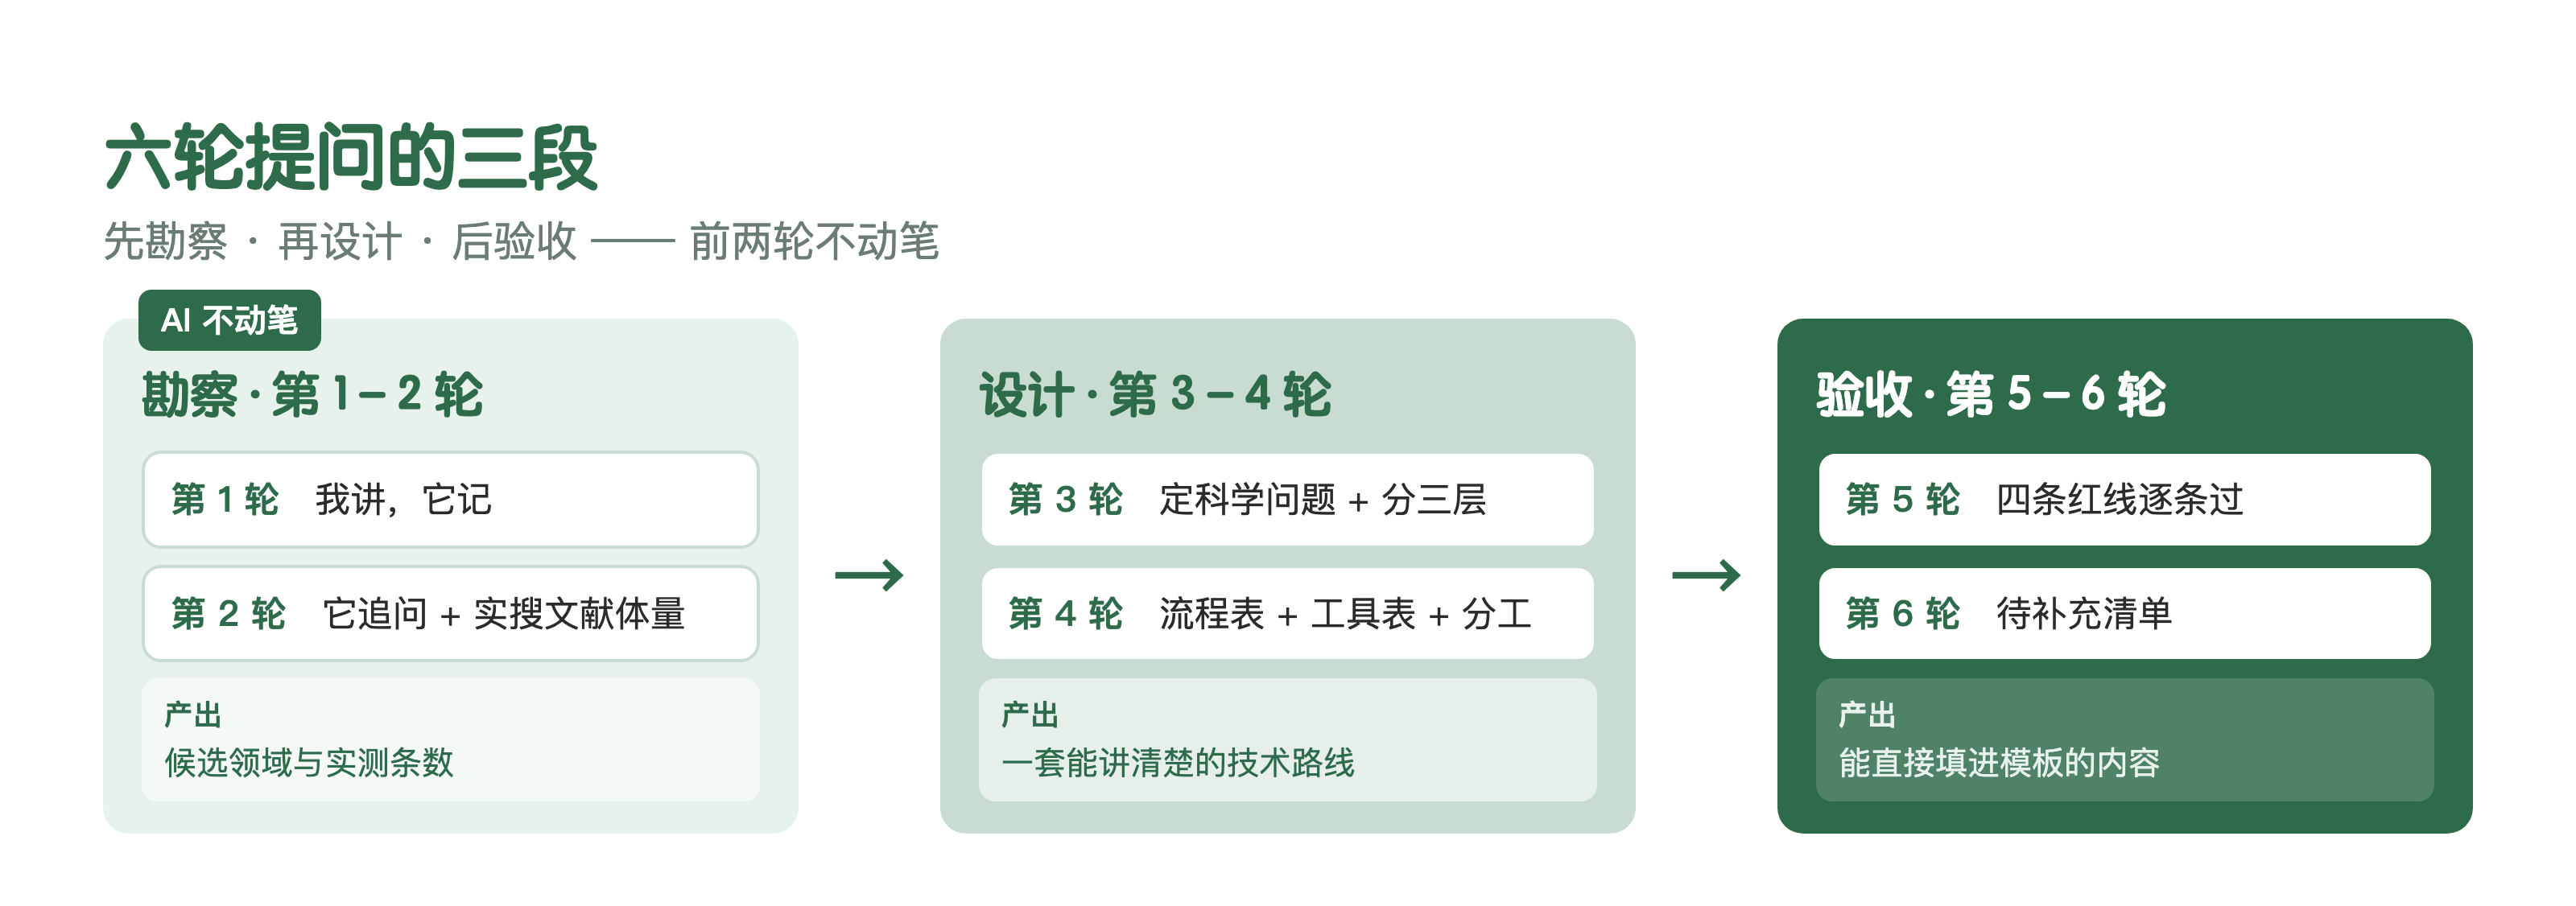 六轮提问的三段:前两轮不动笔
勘察(第 1–2 轮):做什么、拿什么做
第 1 轮我讲,它记:学科背景、会什么不会什么、能投多少时间、手上有什么现成的数据和代码。这一轮它只记录,不评价,不给方案。
第 2 轮它反过来追问:为什么选这个方向、团队怎么分工、有没有领域内能给我把关的人。这一轮还顺带做一件事:把几个候选领域拉出来,到 OpenAlex、arXiv 上真搜一遍看多少条,再看有没有公开数据库和能照着跑的参照工作。选领域的标准就三条:文献多、有公开数据、不靠自己不会的专业。
设计(第 3–4 轮):做到什么程度
第 3 轮定科学问题和角色分工。科学问题要把领域里的困难翻成能检索的形状,常见三类:没人试过的候选、文献之间矛盾的结论、已知体系往外推。这一轮还要先声明一件事:哪些是文献里写的事实、哪些是我跨文献推出来的、哪些只是待验证的假设。
第 4 轮拆流程和列工具。流程每一步写清输入、处理、输出;工具表把官方推荐的、开源的、自己写的分三档列,顺带注明许可证。分工原则我写死了:假设、评估、解释交给模型;去重、单位统一、引用编号、过程留痕交给规则程序。后一类活交给模型只会多一道校对。
验收(第 5–6 轮):怎么算完成
第 5 轮逐条过四条红线,有一条不过就回到对应那一轮重做,不带着毛病往下走。
第 6 轮出待补充清单:团队成员和分工、作品链接、API 成本、领域里能给我把关的人——这些只有我自己能提供,一律显式标出来。清单全绿才进下一步。
六轮里最容易被跳过的是第 2 轮和第 5 轮,一个因为要真去搜文献,一个因为很无聊。跳了的代价都往后面挪:领域选错要从头重写,红线漏掉要重新查引用。
六、30 分钟跑完一轮
这个 30 分钟指的是熟了之后跑一轮的时间,不包括第一次装环境,也不包括提交前的隐私自查。第一次上手把两小时预算进去,后面就快了。
| 步骤 | 时间 | 产出 | 什么算过关 |
|---|---|---|---|
| 六轮提问 | 15 分钟 | 一份回答记录(本地留着,不进仓库) | 六轮都确认过,红线全绿 |
| 填模板 | 3 分钟 | 填好的官方模板文档 | 正文在 3000–5000 字区间,脚本没报标题找不到的错 |
| 模拟评分 | 3 分钟 | 一份打分报告:总分、四维分项、红线检查、强弱项 | 报告拿到手 |
| 照着报告改 | 10 分钟 | 下一版文档 | 红线零警告,弱项清单在变短 |
循环停在哪?我的停法是连着两轮没新增红线警告、弱项清单不再缩短,就不再跑了。模拟分数自己会往上飘,但它不是比赛成绩,盯它没意义,要盯的是弱项里那几条具体意见。
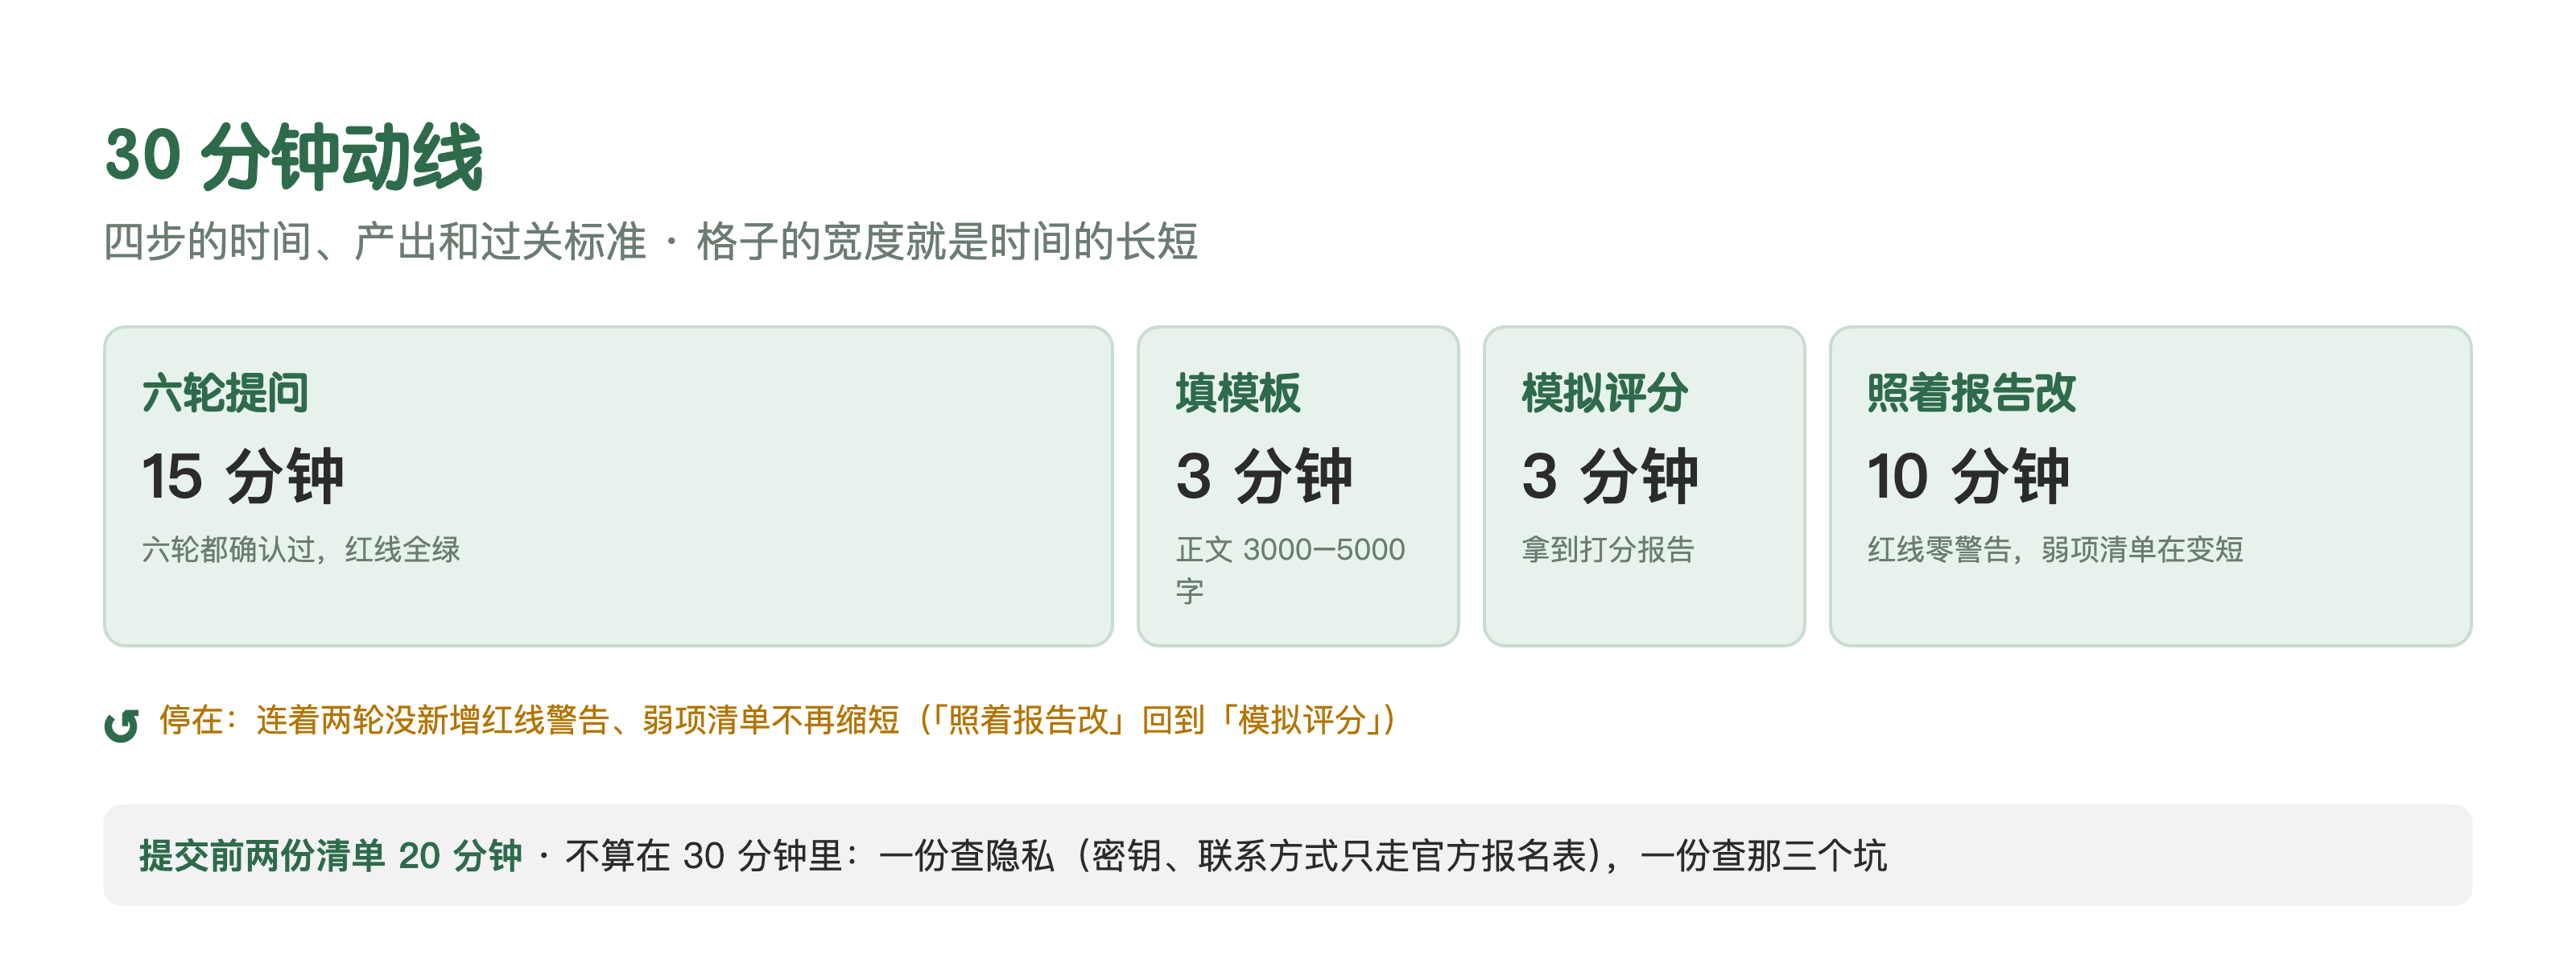 30 分钟动线:四步的时间、产出和过关标准
提交前还有两份清单要过:一份查隐私,密钥、联系方式这类东西只走官方报名表,不进仓库;一份查那三个坑。两份加起来二十分钟,不算在 30 分钟里。
对照着看更清楚
一份方案里的内容按来源分成三类,到底哪些是我跑不掉的活,一张表就看清了。
| 这一块 | 官方给了什么 | 包里备了什么 | 只能我自己给 |
|---|---|---|---|
| 任务与红线 | 赛事手册、四条红线 | 压成一页的背景卡、红线自查清单 | 选哪个方向、选做那三条路走哪一条 |
| 研究领域 | 不指定 | 实测文献体量的问法和三条选型标准 | 定下来哪个领域,并承担选错的后果 |
| 科学问题 | 不指定 | 三类问题原型、事实与假设的区分声明 | 领域里真正卡人的那个问题 |
| 系统设计 | 允许基于开源项目搭 | 角色分工表、模型与程序的分工原则 | 说清自己在开源基底上加了什么 |
| 正文与格式 | Word 模板、3000–5000 字 | 脚本自动填、模拟评分报告 | 这一栏可以全交出去 |
| 团队与成本 | 官方报名表 | 待补充清单 | 成员、分工、作品链接、API 成本 |
最后一栏就是六轮提问要问的全部内容。包里那些东西不能代我回答,只能把问题提到我面前,并且保证我答完之后不用再管格式。
复盘
这一轮省下来的时间,来自四件事:
- 第 2 轮先实测文献体量再选领域。凭感觉选领域,写到一半发现文献不够多,那就是推翻重来
- 把【待补充】当正式产物。缺的东西明确标出来,比让 AI 顺口补上安全
- 把评分标准提前放进去。评分提示词跟官方四个维度同一套口径,改的时候就不用猜
- 模板不动。标题一个字不改,省了排版和说明的扯皮
没省下来的部分也得说:六轮提问里有三四个问题我答得很含糊,后面写到工具表那一节又回去重答了一遍。提问这一步省下的时间,都会在填内容时要回来。
如果只记一句
模板给的是容器,内容得自己提供;六轮提问就是把「自己提供」拆成几个能回答的问题。
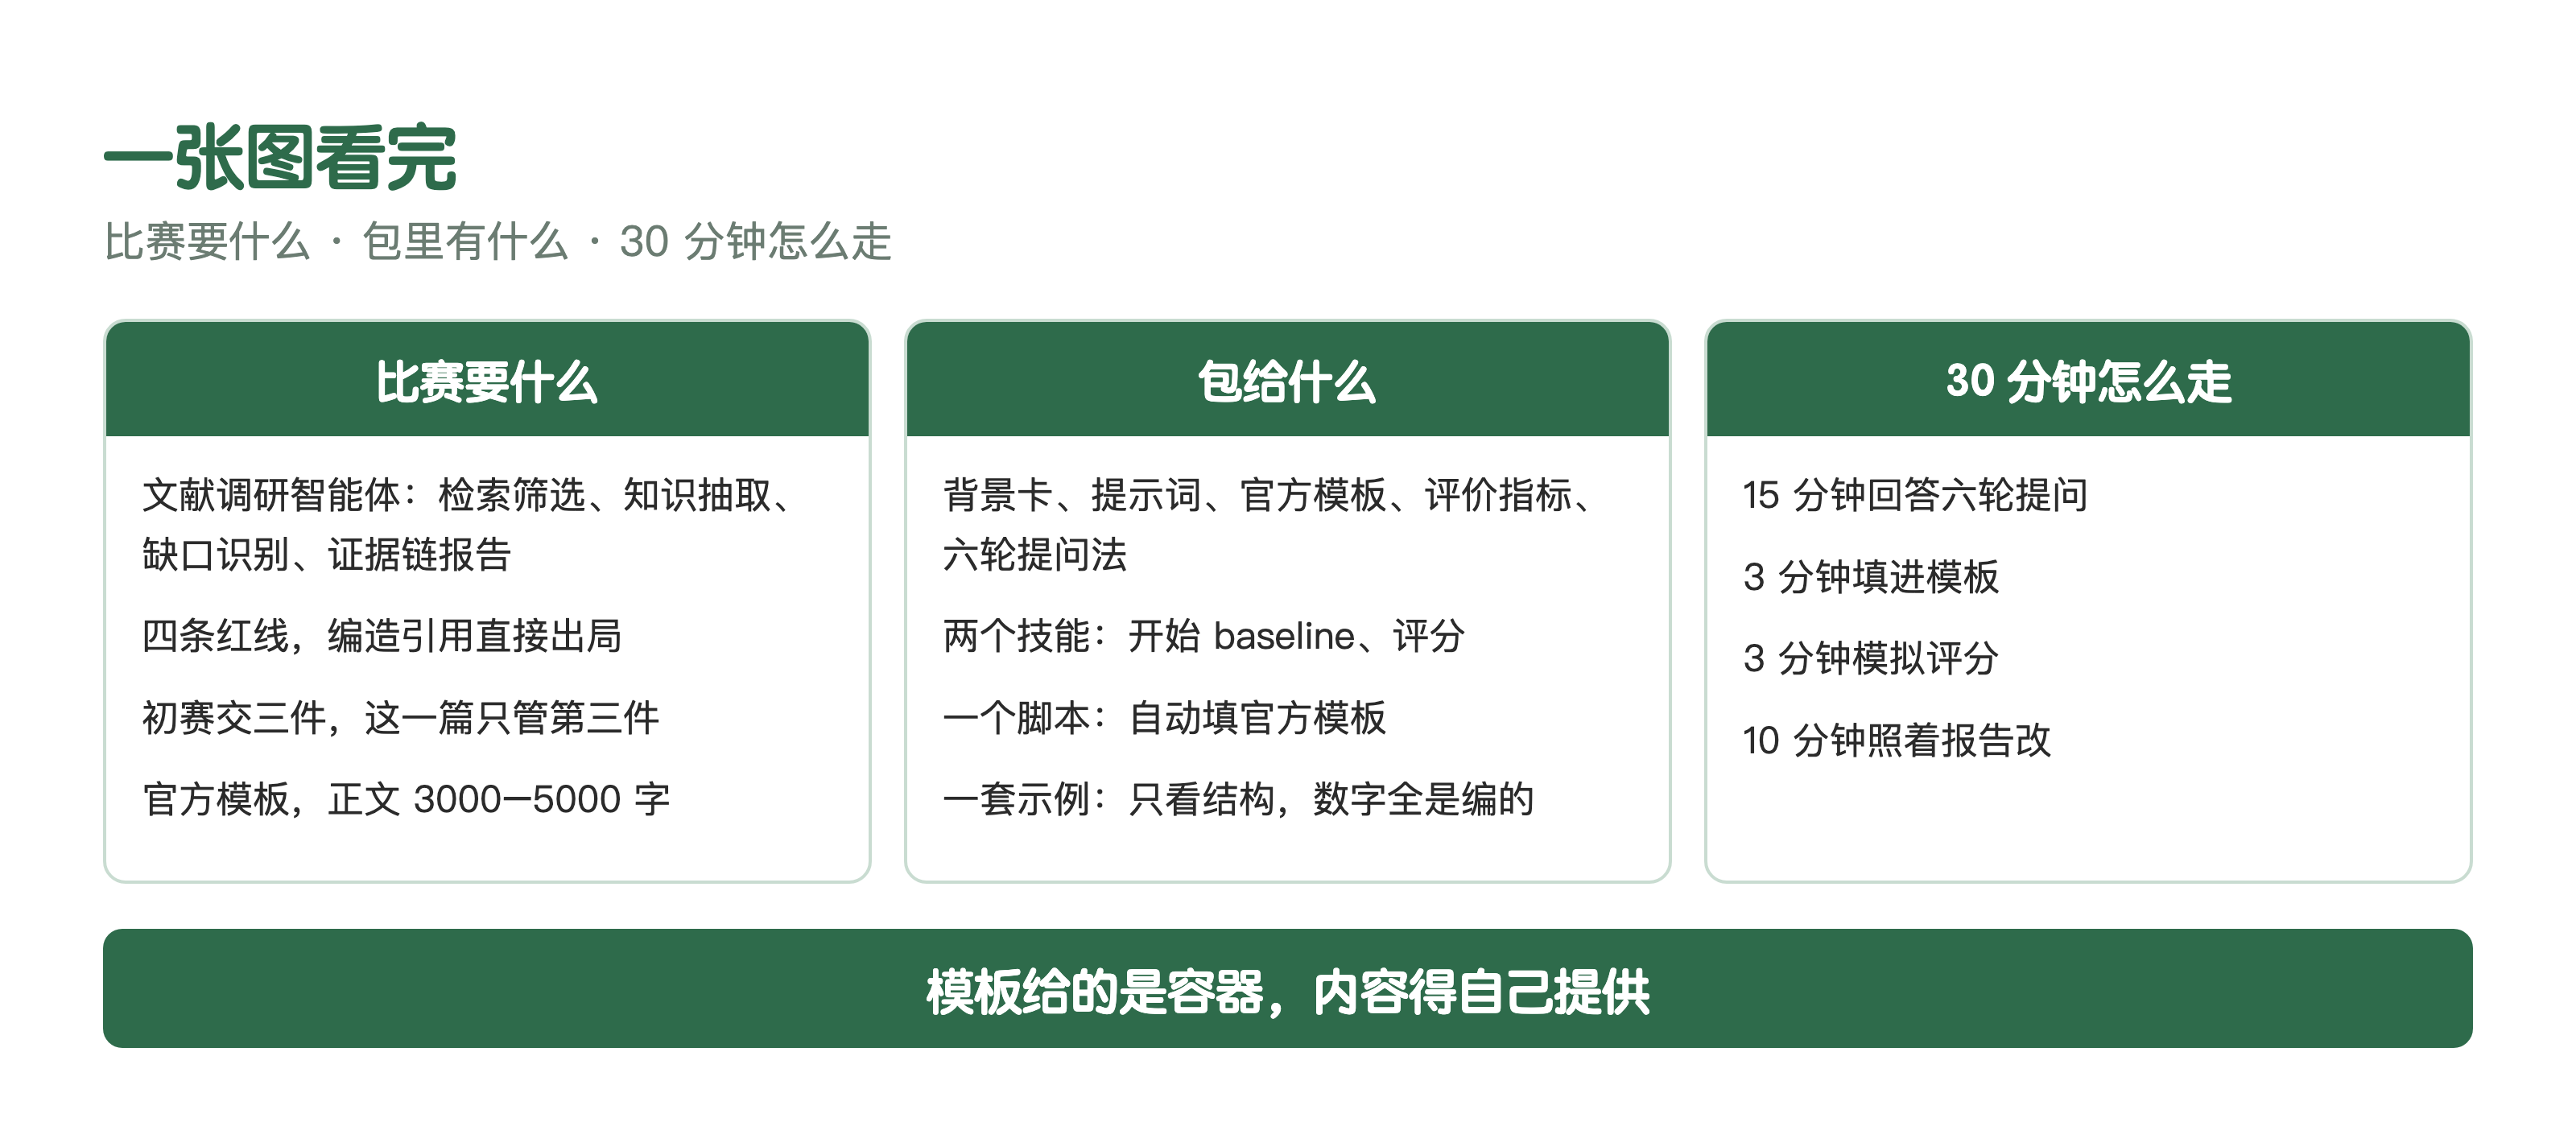 一张图看完:比赛要什么、包里有什么、30 分钟怎么走
下一篇
这套 baseline 跑通之后,我拿同一份任务在 Codex、Claude Code、Claude Science 上各跑了一遍,想看看三家到底差在哪。下一篇讲那三份结果,以及一个比工具本身更难说清的问题:prompt、工具、任务,谁说了算。
📌 这个包是参赛的人自己做的互助工具,不是官方出品,赛题解释权归官方,跟官方不一致的地方以官方为准。里面的 AI 评分是给自己迭代用的,不是官方成绩。所有填写内容必须来自真实背景与实测,缺的地方留【待补充】,不编。